公司花 100 万做的知识库没人用我用一个周末重写了一遍

公司花 100 万做的知识库没人用我用一个周末重写了一遍

瑭宋元
发布于 2026-09-17 21:18:27
发布于 2026-09-17 21:18:27
RAG 不是把文档塞进向量库:四个坑,90% 的团队都踩过
一个真实的复盘
上个月,朋友公司找我去看一套"上線即荒廢"的知识库。供应商交付得很完整:向量库、嵌入模型、前端问答界面一应俱全,验收报告也很漂亮。上线四个月,日均提问 不到 7 次——两百多号人的公司。
我花了两天读完他们的文档集,又花一个周末改了切分、检索和兜底策略。第二周日均提问涨到 130 多次。我没有换模型,没有换向量库,一行 embedding 代码都没改。
一、第一个坑:把 RAG 当成垃圾桶
几乎所有企业 RAG 项目的启动方式都一样:把能找到的文档全塞进去,先跑起来再说。
这个本能是错的。业内有一句话讲得很直白:"立即索引一切"(Index everything immediately)是实施阶段最常见的错误。一个精心整理的 10,000 份高质量、当前文档的索引,通常胜过包含有史以来所有内容的 200,000 份文档索引——包括那份被取代了三次的 2012 年政策。
最能说明问题的是Pryon 的医学 RAG 研究。研究团队拿同一套模型、同一套检索架构,只改源数据质量:
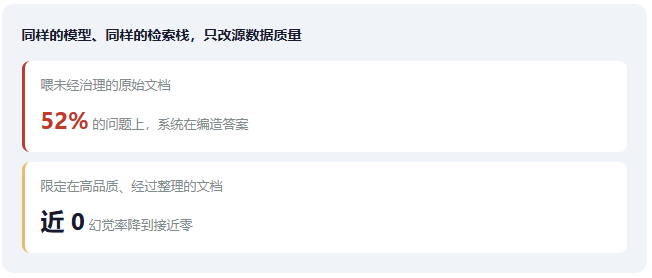
模型没换,检索没换,切分没换。换的只是"喂什么"。
这背后的数据更宏观。Gartner 2025 年 2 月调研了 1,203 位数据管理领导者,63% 的组织要么没有、要么不确定自己是否拥有适配 AI 的数据管理实践;Gartner 同时预测,到 2026 年,组织会放弃 60% 缺乏 AI 就绪数据支撑的 AI 项目。
还有一种更隐蔽的验证。芝加哥大学在 IEEE CAI 2026 发表的研究(arXiv 2512.05411)里测了一件事:在检索前给文档挂上 LLM 生成的元数据(标题、章节路径、生效日期、责任人),会发生什么?
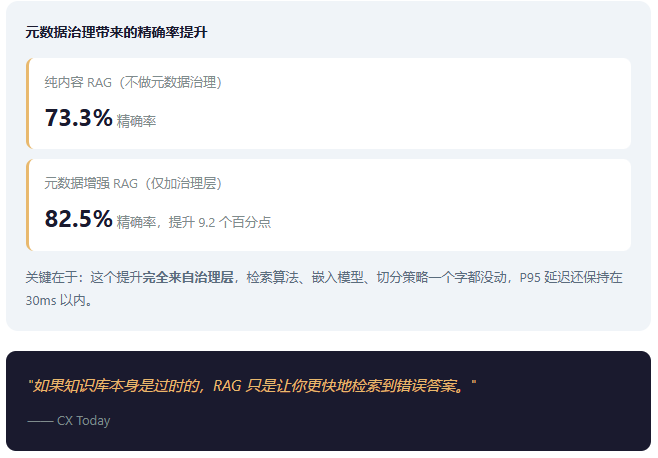
所以知识入库前,必须先回答三个问题:这份文档有明确责任人吗?它的生效日期清楚吗?它和别的文档冲突时,谁说了算?答不上来的文档,宁可不入库——它们不是资产,是噪声源。
二、第二个坑:切分是玄学?不,它是决定上限的工程
切分(Chunking)是 RAG 里最容易被轻视、也最容易出事的一环。行业里有一句被反复验证的话:切分质量几乎决定了 RAG 的性能上限——它决定知识是以连贯上下文呈现,还是退化成无法拼合的碎片。
很多团队遇到"答案断片"就换 embedding 模型、换重排器、调 prompt,收益却常常有限。得物技术团队的复盘说得直接:真正的瓶颈往往潜伏在数据入库之前的一个细节——文档分块。
切分的颗粒度,必须结合具体的内容类型和使用场景来定,不存在一个普适的"最佳大小":
查询类型 | 推荐块大小 | 原因 |
|---|---|---|
事实型问答 | 256–512 tokens | 块里装答案 + 最少噪声 |
分析/总结型 | 1024+ tokens 或页级 | 模型需要更宽的语境来综合 |
混合型(最常见) | 400–512 tokens 起步 | 兼顾召回与精度的中间值 |
中文语料 | 300–800 字 | 对齐 512/1024 token 嵌入窗口 |
重叠(overlap)也一样,不是越大越好。NVIDIA 在 FinanceBench 数据集上用 1024-token 块对比了 10%、15%、20% 三档重叠,结论是 15% 表现最好。中文语料的经验值是 10%–20%,超过 30% 通常只增加索引体积和检索开销,对效果起负作用。
再往上走,是两种值得单独拎出来的进阶策略:
1 父子检索(Small-to-Big)
把文档切成大"父块"(约 2000 tokens),再把每个父块细切成小"子块"(约 200 tokens)。只把子块向量化入库,用子块做精准匹配;命中后回溯返回整个父块给大模型。检索精度因此提升约 15%,存储成本反而降低 20%(微软 Semantic Kernel 实践数据)。
2 句子窗口检索
按句子切细块(100–200 tokens)做检索,命中后动态带上前后各两句一起送进模型。它等价于"动态重叠"——既保证上下文完整,又不用硬编码大量冗余。阿里在医疗 RAG 里更进一步:药品说明书这类术语密集段落用 30% 重叠,患者须知这类叙事段落只用 8%。
还有一个常被忽略的坑:元数据。如果一个 chunk 的内容仅仅是"他签署了这项法案",没有文档标题、章节路径、页码这些元数据,模型根本不知道"他"是谁、"法案"指什么。每个 chunk 必须带上下文标签,这既是检索精度的保障,也是答案可追溯的前提。
补充一个容易被忽略的成本视角:切得太大会把成千上万无关 token 塞进 prompt,你的推理账单会直接爆炸;切得太小则 top-k 要相应放大(块小取 10–15,块大取 3–5),否则覆盖不全。切分是在"上下文完整性"和"信息密度"之间做动态平衡。
三、第三个坑:以为上了 RAG 就没有幻觉了
这是最贵的一个误解。RAG 能显著降低因参数知识缺失导致的幻觉,但它消灭不了幻觉,而且会引入新的失败模式。
斯坦福 RegLab 和 HAI 的研究者做了一件很有意思的事:他们审计了 LexisNexis 和 Thomson Reuters 的 AI 法律研究工具——这两家的产品都因为用了 RAG 而宣称"无幻觉"。结果是,在预先注册的法律查询上,幻觉率在 17% 到 34% 之间。
RAG 确实有用,同样的查询裸跑 GPT-4 幻觉率更高。但"降低"和"消除"之间那道鸿沟,恰恰就是生产系统所在的位置。
更反直觉的是 2025 年 11 月的一项医学 RAG 研究:18 位医学专家,对 800 条 RAG 输出做了 80,502 次标注。结论是——标准 RAG 不但没提升,反而让事实性下降最多 6%、完整性下降 5%。为什么?根因在 LLM 之前:top-16 检索回来的段落里,只有 22% 是相关的。
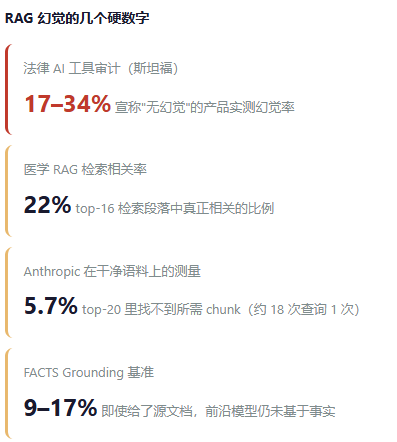
为什么降不干净?三个结构性原因:
1 检索失败发生在生成之前
RAG 失败的经典分类里(Barnett 等人的七个失败点),有三个发生在 LLM 生成任何一个 token 之前:内容缺失、漏掉本该排第一的文档、上下文整合失败。这些是检索层的问题,换模型一个都解决不了。
2 模型被训练成"宁猜不说不会"
OpenAI 在《Why Language Models Hallucinate》里讲得很清楚:标准训练和评估奖励猜测、惩罚弃权——多选题里空着得零分,蒙一个还有对的可能。SimpleQA 上的对比极其直白:一个推理模型只弃权 1%、错了 75%;另一个弃权 52%、错误率降到 26%。
3 两个方向的失真都会发生
RGB 基准测的是"只给不相关文档时模型会不会拒答"——表现最好的模型拒答率也只有 45%,意味着拿一堆垃圾上下文,它照样一本正经地答。而 ClashEval 测出的是镜像失败:当检索到的错误内容与模型本来正确的知识冲突时,超过 60% 的情况模型会放弃自己的正确答案,转而相信那段错的上下文。
企业场景还有更麻烦的三种:一是多文档矛盾,ERAA-2026 基准显示 51% 的多文档综合答案会遗漏检索文档中的实质性冲突,模型倾向于给一个"抹平分歧"的答案;二是时间错乱,带时间限定的问题幻觉率 29%,远高于普通问题的 9%;三是引用幻觉,38% 的引用指向的文档并不能完全支持它要证明的说法,行业新指标 CSR(引用支持率)平均值只有 0.62。
所以对苛刻场景,我的建议很明确:RAG 前面必须再加一道传统问答知识库。
具体做法是"分层兜底"——把高频、标准、答案唯一的问题(年假几天、报销标准、账号怎么重置)抽出来,做成人工审定过的确定性问答对,命中就直接返回标准答案,不经过大模型。只有长尾、非标、需要综合性的问题才走 RAG 生成。这一层不酷,但它把最不能出错的那部分问题,从"概率正确"变成了"确定正确"。
"RAG 把模型的创造力关进了文档的笼子里。但笼子的栏杆有多密,取决于你喂进去的文档——以及你承认它仍有缝。"
四、第四个坑:迷信向量检索,忘了 BM25
泛化差 ≠ 没用,精确率往往比你想的高得多
这几年向量检索太火,火到很多团队默认"RAG = 向量数据库",把关键词检索当过时技术扔掉了。这是一个代价高昂的误会。
先看一组真实查询分布上的实测 NDCG 对比:
查询类型 | BM25 | 向量 | 混合 |
|---|---|---|---|
精确关键词 | 0.94 | 0.29 | 0.89 |
语义/改写 | 0.22 | 0.85 | 0.82 |
混合意图 | 0.48 | 0.56 | 0.80 |
对抗性 | 0.15 | 0.40 | 0.44 |
总体 | 0.43 | 0.54 | 0.73 |
注意第一行:精确关键词查询上,BM25 的 0.94 几乎碾压向量的 0.29。原因很朴素——向量检索擅长"意思相近",却对专有名词、产品型号、错误码、法条编号、人名地名这些"必须一字不差"的东西相当迟钝。你搜"API 错误码 429",它可能给你返回一堆关于"服务器超时"的语义相近内容。
反过来,语义查询上 BM25 只有 0.22,向量 0.85。两者各有盲区,且盲区几乎不重叠——这正是混合检索成立的前提。
召回率的差距更关键。Recall@20 上,混合 0.80、向量 0.62、BM25 0.51。对 RAG 而言这不是抽象指标:0.80 与 0.62 的召回差距,就是"好答案"和"幻觉"之间的距离——找不到正确上下文,模型就只能编。
还有一个反直觉的研究结论值得记住。Vespa 团队在 13 个 BEIR 数据集上测了混合效果:
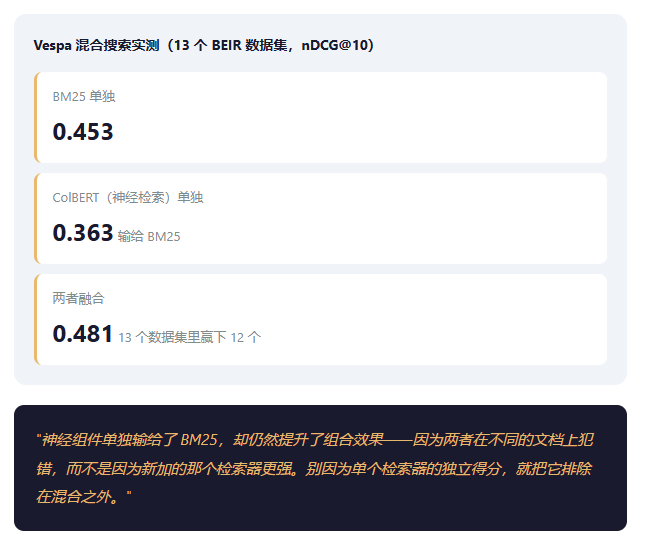
落地上有两个必须避开的坑:
1 分数不做归一化就相加
这是真实的生产事故,不是理论风险。BM25 没有上界(随词频、词稀有度、文档短度往上走),而余弦向量分数通常挤在远小于 1 的窄带里。两者直接相加,无上界那一支会直接主导排序,向量分支等于白跑。
2 忽略最弱分支的破坏力
Vespa 那 13 个数据集里唯一输的一次是 CLIMATE-FEVER:平均 20.2 词的查询撞上 32 wordpiece 上限,ColBERT 得分掉到 0.067,融合近似噪声反而把结果拖到 BM25 单独之下。所以融合前,务必确认每个分支在你的真实查询分布上都不塌。
推荐做法是用 RRF(Reciprocal Rank Fusion)做融合:它只用排名、不用分数,天然绕开尺度不一致的问题,公式是 RRF_score = Σ 1/(k + rank_i),k 取 60 是常用平滑常数,无需调参、无需训练。延迟上,两个检索并行跑,BM25 那一路几乎是"免费"的——实测 p50 从向量单独的 1.2ms 到混合的 1.5ms,只多 25% 就换来 14 个点的 NDCG 提升。真正的成本不是延迟,是运维:两套索引必须保持同步。
五、那个周末,我到底改了什么
没有换模型,没有换向量库,没有重构架构。改动集中在六件事上:
1 清洗库:从 18 万份砍到 2.3 万份
删掉过期版本、草稿、重复件、OCR 质量差的扫描件。每份入库文档必须有责任人和生效日期。这是提升最大的一步。
2 按文档类型分别定切分策略
制度类走父子块(子 200 / 父 1500 tokens),手册类按标题层级切,表格整表转自然语言描述,代码用 AST 感知切分。不再"一把尺子量所有文档"。
3 给每个 chunk 补元数据
文档标题、章节路径、生效日期、适用部门、密级。这一步单独就能带来接近 9 个点的精确率提升,而且是纯赚。
4 检索改成 BM25 + 向量,RRF 融合
k 取 60,两路并行,各取 top-50 再融合,最后过一遍 cross-encoder 重排到 top-5。召回上来了,断片问题立刻少了一半。
5 加一层确定性问答兜底
把历史日志里出现频次前 200 的问题抽出来,人工审定标准答案,做成精确匹配的问答对。命中直接返回,不过模型。这 200 个问题覆盖了大约 60% 的真实提问量。
6 低置信度直接转人工,不许硬答
检索最高分低于阈值,就回"文档里没找到,已转人工",并附上可能相关的三篇原文链接。涉及金额、合规、人事的问题,强制给出原文出处。用户被错误答案坑两次,就再也不会用第二次了。
六、这五种情况,你根本不该上 RAG
说了这么多怎么改,但更有价值的问题可能是:什么时候干脆别做。
1 文档本身就乱得没法看
文档散落在个人电脑、微信群、邮件里,连一份集中 Wiki 都没有。先花三个月把文档集中、分类、落实责任人,再谈智能化。往垃圾里塞向量,出来的还是垃圾。
2 每天问答量不到 50 次
雇一个兼职资料员,成本比上一套 RAG 低得多。ROI 是负的。
3 零容错的敏感内容
法律合规文档、投融资数据、核心代码库。AI 漏一句,损失可能远超它省下的钱。先做人审流程,AI 只做辅助检索,绝不直接给答案。
4 更新速度远超维护能力
业务规则一天一变,但没人专职维护知识库。索引永远追不上文档,AI 就永远在答错。
5 要求 100% 准确的场景
医疗建议、法律判决、财务报税。这类场景可以做"辅助检索",让人来下结论,但绝不能做"自动给答案"。
三个问题自测:文档集中吗?有人维护吗?允许偶尔答错吗?三个里有一个答"不",就先别上 RAG。先把文档治理做好,再谈智能化。
结语
那套 80 万的系统,问题从来不在技术选型。向量库是主流方案,嵌入模型不算落后,架构也没错。真正的问题是:团队把 90% 的精力花在了那 10% 的工作上——把 PDF 塞进向量库,然后期待模型自己搞定剩下的事。
RAG 是一个"文档质量决定上限、工程细节决定下限、运营投入决定能活多久"的系统。文档清洗、切分策略、权限隔离、冲突处理、溯源机制、持续运营——每一步都是脏活累活,但每一步都决定了你做出来的到底是个能用的工具,还是个没人信的电子垃圾桶。
向量库只是个开始。真正贵的,从来是那些不酷的脏活。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-31,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号