成本降 80%、收入涨 27 倍智谱中报里的「通缩式增长」

成本降 80%、收入涨 27 倍智谱中报里的「通缩式增长」

瑭宋元
发布于 2026-09-17 21:28:25
发布于 2026-09-17 21:28:25
单位 Token 推理成本较年初下降 80%,开放平台及 API 收入却同比暴增 27 倍——降价还能涨价?这不是财报数字打架,是 Token 经济的第一性原理
8 月 31 日傍晚,智谱在港交所披露 2026 年中期业绩——这是它今年 1 月上市后的首份中报。
有两个数字,放在一起看非常反常:
单位 Token 推理成本,较年初下降约 80%。
开放平台及 API 业务收入,同比增长 2735.7%(约 27 倍)。
成本降了八成,收入却涨了二十七倍。按常识,降价应该压缩收入才对。这正是 Token 经济最反直觉的地方。
一、先把中报摊开:收入结构换了一次血
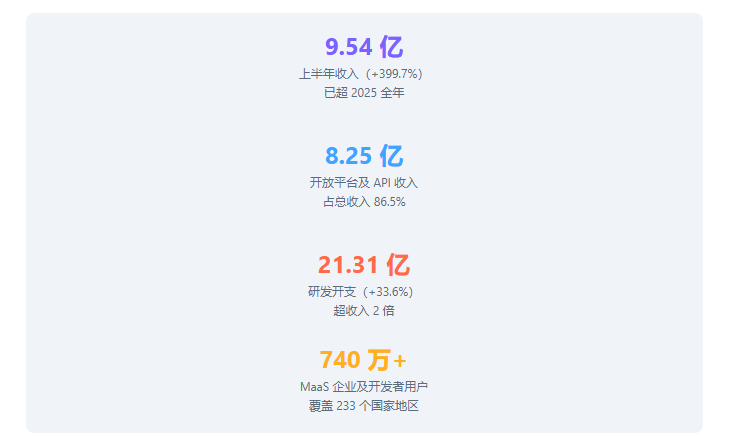
智谱董事会秘书肖磊在电话会上说了一句很关键的话:「相较收入增速,收入构成的切换更值得关注。」
业务 | 2026H1 占比 | 同比 |
|---|---|---|
开放平台及 API | 86.5% | +2735.7% |
企业级智能体 | 5.8% | +304.4% |
企业级通用大模型(本地化部署) | 7.0% | −54.6% |
技术服务及其他 | 0.7% | +1166.7% |
数据来源:智谱 2026 年中期业绩公告(2513.HK),2026-08-31
看明白了吗:本地化部署收入占比从去年同期的 73.7% 掉到 13.5%,按调用计费的 API 从 26.3% 冲到 86.5%。一家过去靠政企项目吃饭的公司,半年之内把收入重心整个换到了云端。而让这次换道成为可能的,正是那条下移的成本曲线。
二、最反常识的一组数字:成本降 80%,售价却涨了 101%
这是整份中报里最值得停下来想 30 秒的地方。成本在暴跌,API 平均售价却同比提高了约 101%,而且毛利率还从 −0.4% 翻正到 24.6%。
同一时期,两个方向相反的变量
API 平均售价 提高约 101%
单位 Token 推理成本 较年初下降约 80%
同期 API 业务毛利率由 −0.4% 提升至 24.6%,实现由负转正
这不是数字打架。智谱董事长刘德兵在电话会上给出了标准答案——未来行业会出现两条价格曲线:
「同等智能的价格会持续下降,但能打开新任务边界、显著提升任务成功率的模型仍有定价空间。」
拥有定价权的不是 token 本身,而是 token 最终能完成什么任务。
翻译一下:降的是「同等智能」的价,涨的是「更高智能」的溢价。成本下降让低价供给成为可能,而提价 101% 还能卖出去,是因为模型已经能干更难的活了——从"回答一个问题"变成"独立完成一个工程项目"。你买的从来不是 Token,是 Token 换回来的那个结果。
三、杰文斯悖论:为什么降价反而让收入暴涨
还是没解释收入为什么能涨 27 倍。答案是用量涨得比价格跌得快得多:
放量指标(统一折算为「增长倍数」)
前十大客户日均调用量 较年初 +98 倍
MaaS 平台 Token 调用量 较年初 +40 倍
Coding Plan 调用量 +23 倍
付费日活用户 +603%(约 6 倍)
数据来源:智谱 2026 年中期业绩公告及业绩会
这就是经济学里著名的杰文斯悖论(Jevons Paradox)。1865 年,经济学家杰文斯在《煤炭问题》里指出:蒸汽机效率提升,反而会让英国的煤炭总消耗量增加——因为更高效的机器让煤炭在更多原本不划算的场合变得可用。
AI 正在复现同一条曲线:
现象 | 数据 |
|---|---|
Google 月度 Token 消耗 | 2025 年内由约 480 万亿 增至约 1.3 千万亿 |
Gartner 预测推理成本 | 到 2030 年较 2025 年下降超 90% |
高盛预测 Token 消耗 | 2026→2030 年月度消耗增长 24 倍 |
Agent 的放大效应 | 同一业务结果下,智能体工作流比普通对话多消耗约 5–30 倍 Token |
结论:这叫「通缩式增长」。单价在通缩,用量在通胀,而用量增速远超价格降幅,所以总收入反而暴涨。谁要是拿传统制造业的「降价 = 收入下滑」常识来看 AI,会完全看错这门生意。
四、唐杰公式:智能上限 × Token 消耗规模
整份中报里我最想推荐的是智谱首席科学家唐杰给出的这个公式:
AGI 的商业价值 = 智能上限 × Token 消耗规模
前半截决定「单个任务值多少钱」 后半截决定「有多少任务真实发生」
智谱上半年其实就在同时推这两个变量。看智能上限这一侧:
GLM 系列智能指数(Artificial Analysis Intelligence Index)
2026 年 8 月 60
约 11 个月前 32
11 个月完成 4.6→5.3 六代迭代,单任务成本稳定在 0.2 美元档
而成本下界这一侧,靠的是双模型策略:
模型 | 智能指数 | 单任务成本 |
|---|---|---|
GLM-5.3 | 60 | 约 0.68 美元 |
GLM-5.3-Flash | 57.5 | 0.045 美元 |
用 2.5 分的智能差距,换 15 倍的成本下降。GLM-5.3-Flash 用 320B 总参数 / 18B 激活参数的混合架构,把服务成本打到 GLM-5.2 的十分之一。它的匿名版 Ox-Alpha 曾登顶 OpenRouter 调用量榜首,6 天累计调用超 62T Token,身份揭晓当天即以 MIT 协议开源。这就是「智能—成本」帕累托前沿的实际打法。
五、能力阶梯:定价权随任务层级一起上移
智谱把商业化路径划成五级,每一级都有一道具体的技术门槛把着,门槛跨不过去,上一层的商业模式就不成立:
层级 | 交付什么 | 门槛 |
|---|---|---|
Chat | 一次回答,一轮内结束 | —— |
Coding | 一段可运行的代码 | 结果可验证(能跑通或跑不通) |
Agent | 一条被执行完的多步任务链 | 长程规划 + 错误恢复 |
Co-work | 一份可被专业人士复核的成果 | 专业人士愿复核,而非推倒重做 |
Autonomous AI | 无人值守下承担长期目标 | 模型能自己判断做得对不对 |
每上一级,对应的市场空间也逐级放大(下列为智谱公司基于公开行业数据的粗略估算,未经独立核证):
Autonomous AI / 长期重构 约 30 万亿美元
Co-work / 知识工作 约 5 万亿美元
Coding / 软件研发 约 5000 亿美元
Chat / 搜索 约 1000 亿美元
公司公告明示:该估算仅供说明任务层级与市场规模的对应关系,不构成业绩预测或保证
看懂这张阶梯图,就懂了刘德兵那句话的分量:越往下的层级越按「量」计价,越往上的层级越按「成果」计价。卖 Token 是最不值钱的生意,卖"交付的结果"才有定价权。海通国际在同一时期的研报里也说得很直白:模型层定价权仍将承压,价值加速向云和基础设施迁移,能够对最终任务结果负责的产品更具定价权。
六、算力乘数:从「有多少卡」到「产出多少有效 Token」
中报里还有一个被低估的指标:单位算力(含训练与推理)所对应的收入,同比提升约 14 倍。
支撑它的是 All-in-Infra 战略——自 2026 年初起把国产芯片纳入主力推理算力,实现十万卡级国产芯片的规模化部署。
肖磊的判断值得抄下来:算力行业的主要矛盾,已经从「国产芯片能不能跑」转向「如何验证国产芯片的经济性」。简单把卡加起来并不能反映真实供给能力,真正该看的是「有效算力」——有多少算力已安装、能稳定调度、长期运行,并最终转化成有效的 Token。
七、必须说清的三个口径(别被 headline 骗了)
这份中报很漂亮,但有几个地方必须掰开看,否则容易被单一数字误导。
1. 亏损:两个口径,方向相反。期内亏损 20.72 亿元,同比收窄 12.1%;但经调整净亏损 19.64 亿元,同比扩大 12.1%。看「期内亏损收窄」还是「调整后亏损扩大」,结论完全两样。研发开支 21.31 亿元,已经超过收入的 2 倍。
2. 毛利率仍然偏低。整体毛利率 26.4%,API 业务毛利率 24.6%。对比传统 SaaS 动辄 70%+ 的毛利,这说明「降价换规模」与「推理成本」仍在角力——规模跑出来了,但还没跑出利润。
3. 口径差异要标注。①那组 100B/500B/5T/30T 是公司自己基于公开数据的粗略估算,未经独立核证,公告里自己都写了「不应过度依赖」。②ARR 有两个口径:按 8 月月度收入年化约 16 亿美元;按「单周收入 ×52」的激进口径则超 20 亿美元。③本地化部署收入同比 −54.6%,既是主动换道,也意味着丢了一块原本稳定的基本盘。
八、给从业者:Token 经济的四条生存法则
1. 别做「卖 Token」的生意。基础 Token 正在快速商品化——智谱这种头部厂商的 API 毛利率也只有 24.6%,开源模型就是价格天花板。你如果只做转售和搬运,毛利会被一路压到零。
2. 做「卖任务结果」的生意。定价权在往 Co-work 层级上移:谁对最终交付的成果负责,谁才有溢价空间。这也是为什么「按 Token 计费」正在被「按任务 / 按订阅计费」替代。
3. 盯「单位智能成本」,别盯参数。GLM-5.3 与 5.2 同架构、同参数,唯一变量是后训练规模,端到端完成率就提升超 50%。在推理时代,最优解从「更大的模型」转向「更小的架构、训练更久」。
4. 把 Token 消耗当一等工程指标。Agent 工作流比普通对话多消耗 5–30 倍 Token。很多团队按「对话级」成本做预算,却部署了「Agent 级」负载,等账单出来才发现对不上。Token 消耗要和延迟、错误率一样被监控和告警。
结 语
回到开头那个反常的组合:成本降 80%,收入涨 27 倍。
它背后是 Token 经济最核心的一条规律——单价在通缩,用量在通胀,而用量涨得永远比价格跌得快。蒸汽机让煤炭更省,却让人类烧掉了更多煤;更便宜的智能,也不会让我们用得更少,只会用得更狠。
所以真正值得记住的不是那 80%,而是唐杰那个公式的后半截:决定天花板的不只是智能有多强,更是有多少任务,真的被交给了它。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-02,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号