Jev 能做什么、不能做什么?适用场景与九大失败模式盘点
原创
Jev 能做什么、不能做什么?适用场景与九大失败模式盘点
原创
克劳德2048
发布于 2026-09-23 19:46:41
发布于 2026-09-23 19:46:41
用一个新模型,最贵的学费往往不是学会怎么用,而是搞不清它在哪里会翻车。这一周我把 Jev 放进几类真实任务里试了个遍,也逐条对照了官方公开的弱点清单,越来越确信一句话:用好 Jev 的前提,是先把它的边界摸清楚。这篇文章我把适合它的场景、官方明确列出的九项弱点、以及每类问题对应的正确做法都盘一遍,帮你在踩坑之前就把界划好。文中场景与弱点清单来自官方文档与我参考的第三方实践,Jev 仍处早期访问阶段。
一、它擅长的,是"聪明的 if 语句"
先说适合的。Jev 的主场是高频、低延迟、可被代码直接消费的判断型任务。我在项目里用得最顺的有这么几类:
意图路由与分类,把一条进来的请求判定类别、分发到对应的处理器。工作流分支,一次调用同时问多个问题(该转谁、多紧急、是否投诉),各自返回后代码分别走分支。大规模文档批量打分,对海量文档做分类或打分,成本以美分计。给大模型输出做评分和护栏,判断一段回答质量如何、是不是越狱或提示注入。
下面这张图把"适合"和"不适合"放在一起,是我随手就能对照的边界图:
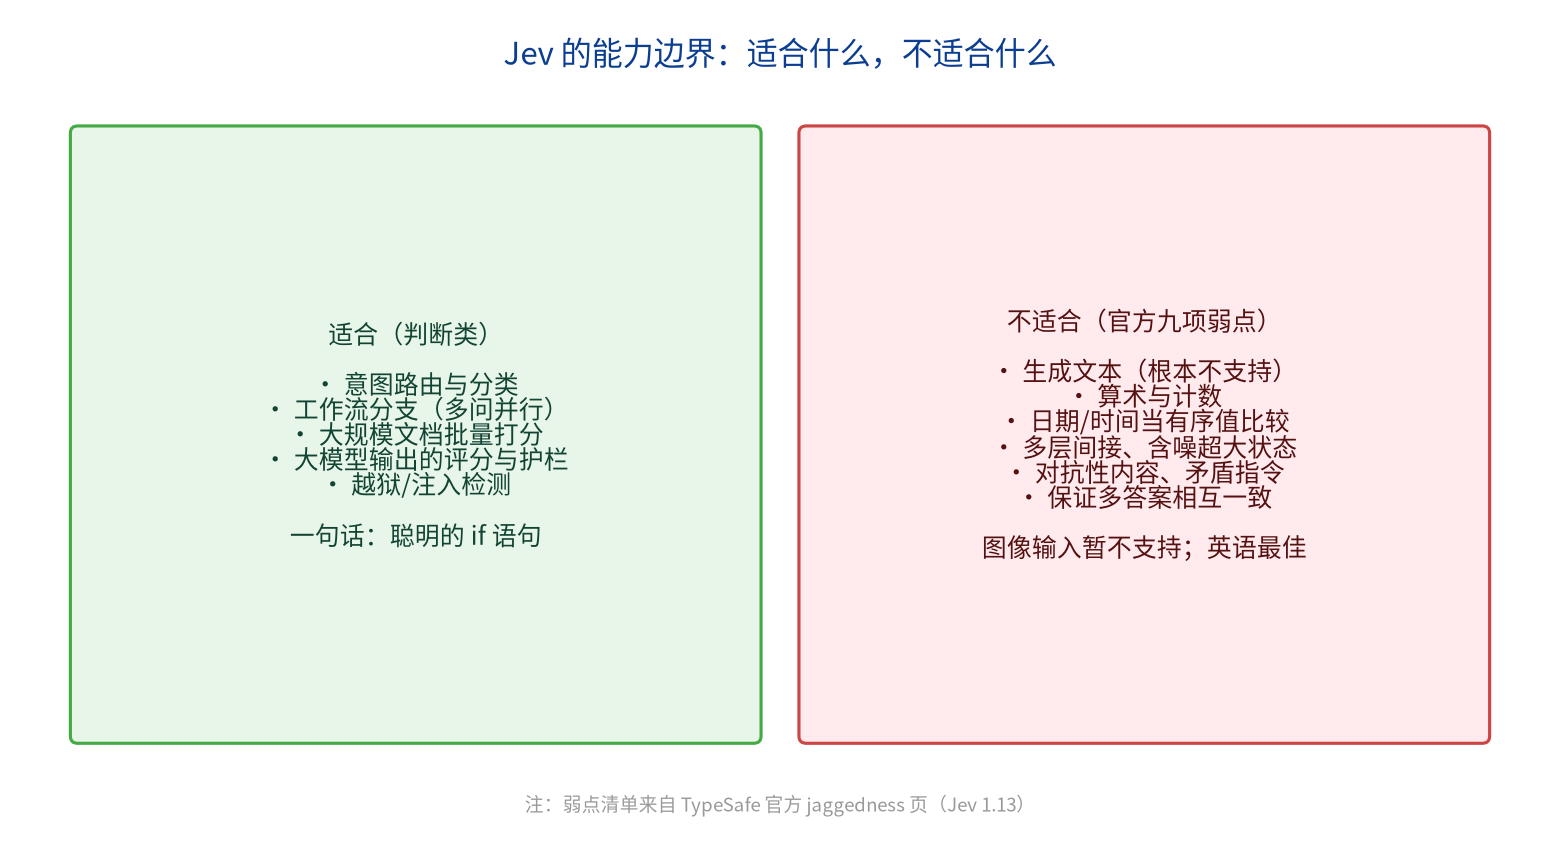
Jev 的能力边界:适合什么,不适合什么
一句话概括适用范围:凡是能写成"聪明的 if 语句"的判断,都是它的主场。
二、官方公开的九项弱点,逐条盘
TypeSafe 为 Jev 公开了一份"能力不均匀"清单,我认为这是整套文档里最有用的一页,因为它直接告诉我边界在哪。九项弱点如下:
弱点 | 含义 |
|---|---|
按字面读指令 | 它回答你写的问题,而不是你想问的问题 |
算术与数字 | 不是计算器,计数不可靠 |
日期时间比较 | 把日期当文本读,不当有序值 |
多层间接 | 额外的间接层级会让它表现变差 |
含噪超大状态 | 状态越大越杂,准确率越低 |
对抗性内容 | state 里的内容可能左右答案 |
矛盾的指令与标准 | 遇到冲突不会自行调和 |
结构一致性 | 不保证两个答案彼此逻辑一致 |
生成 | 完全不能生成文本,这是设计使然 |
三、每类问题的正确做法:把逻辑留在代码里
好在这份清单每一项都配了"改用什么"的建议,而且几乎都指向同一个原则:把逻辑留在代码里,只给 Jev 那个它擅长的窄判断。
需要算数或计数,我先在代码里算好,再把结果作为 state 交给它做纯判断。需要比日期,我在代码里比完,只让它回答"是否在期限内"这种布尔问题。遇到复杂的多因素决策,我拆成若干个原子问题,各自问、代码组合。状态太大太杂,我先做裁剪和抽取,只把相关信息喂进去。要保证多个答案一致,我不指望模型,而是在代码里加约束校验。
这套做法的共同点是:不跟它的弱点较劲,而是绕开弱点、只用它的长处。
四、几个明确不该用它的场景
有些场景我会直接排除,不做尝试。
任何需要生成文本的任务,写回复、写总结、写代码,它根本不参赛。需要可追溯推理链的强监管审查,金融、医疗、法律合规往往要求"给出理由",而 Jev 只给数字和概率、不给解释,这类场景我会保留大模型或人工。图像、音频、视频输入,它目前只支持文本。非英语的长文本,官方称它对英语支持最好,其他语言准确率不一,长文本还要考虑上下文长度限制。
五、对抗性内容与"字面读",是我最警惕的两点
九项弱点里,有两点在真实系统里最容易造成隐患,我单独拎出来。
一是对抗性内容。state 里如果混入了用户可控的文本,就可能被人构造内容去影响判断结果。凡是 state 含有不可信输入的场景,我都会在外层加防护,而不是完全信任它的判断。
二是"按字面读指令"。它答的是我写的问题,不是我心里想的问题。所以问题的措辞要精确,评分标准的每一档要界限分明。第三方实测也印证了这点:问题写得越谨慎、越间接,一致率反而越低。把问题写清楚、写直接,是提升它表现最省力的办法。
六、边界即用法
盘完这一圈,我最深的体会是:Jev 的能力边界不是它的缺点,而是它的说明书。它从设计上就只做一件事,在给定选项里做带概率的判断;凡是超出这件事的,它都不该被指望。理解了这一点,用它就变得很简单:把系统里那些"高频、原子、答案空间固定"的判断挑出来交给它,把生成、计算、复杂推理留给该做的组件。边界划得越清楚,它跑得越稳。它会不会持续进化、补上某些弱点,还要看后续版本,但就现在而言,按它的边界来用,就是用好它的全部秘诀。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号