大语言模型的基石:Transformer 入坑笔记(五) - 线性注意力(Linear Attention) 的优化

大语言模型的基石:Transformer 入坑笔记(五) - 线性注意力(Linear Attention) 的优化
owent
发布于 2026-10-26 12:50:14
发布于 2026-10-26 12:50:14
背景
前文 《大语言模型的基石:Transformer 入坑笔记(四) - 线性注意力(Linear Attention) 的基础》 介绍了线性注意力的基本思路:把历史 K/V 压进固定大小的状态,避免每次读出都遍历完整历史。 但计算量降下来以后,还有两个问题:有限状态该怎样保留和更新信息,以及怎样把递推计算组织成 GPU 擅长的大块矩阵运算。
各家 LLM 对长上下文的解决方案并不完全一致。Kimi K3 发布后,我自己体验下来效果相当好,也因此想了解它所用的 KDA。 此前公开的 《Kimi Linear: An Expressive, Efficient Attention Architecture》,正好给出了这条路线的设计和实验。
这篇继续梳理 Performer、DeltaNet、GLA、Mamba-2 / SSD 和 Gated DeltaNet,重点放在状态更新与分块计算上。最后再到 KDA 的逐通道 Delta 更新。
涉及的论文比较多,我也是零散地抽时间看和理解,阅读周期拖得比较长。这里主要记录公式和计算过程,性能结果以各论文报告的实验条件为准。
为什么要优化线性注意力?
先回顾前文的基础形式。以下按单个注意力头推导,q_t,k_t,v_t 都是列向量;Q,K,V 分别把这些向量的转置按行堆叠。输出统一记作列向量 o_t。
标准注意力是 O=\mathrm{Softmax}\left(QK^T/\sqrt{d_k}\right)V。用于自回归生成时,每个位置只能访问自己及之前的 token,需要屏蔽未来位置,这也称为单向注意力。
基于特征映射的线性注意力则选择一个非负特征映射 \phi,用映射后向量的内积计算相似度。这种相似度函数在数学上称为“核函数”。在同样的单向可见范围内,输出写成
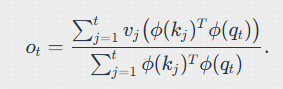
选择不同的 \phi 通常会得到不同的相似度函数;只有明确构造了近似关系,才能说它是在逼近 softmax 注意力。
然后我们继续引入两个累积量:
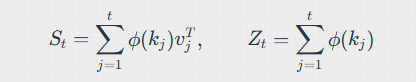
就有
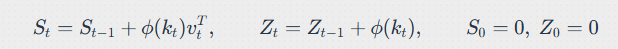
输出:
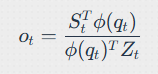
S_t\in\mathbb{R}^{d_\phi\times d_v} 和 Z_t\in\mathbb{R}^{d_\phi} 的大小不随上下文长度增长。代价是所有历史 token 都被压入同一个有限状态,无法像全注意力那样逐项访问历史 K/V。纯加法递推没有随时间衰减的因子;历史增加时,相近 Key 的写入可能相互干扰,归一化后某条信息所占的权重也可能变小。这与按时间衰减旧状态是两种不同的机制。
所以后续改进大致围绕这个方向:选什么特征映射;遇到新的 Key/Value 对时怎样改写 S;哪些旧状态应该衰减;固定状态能否保留任意多条可精确检索的信息?
Rethinking Attention with Performers - 用正交随机特征逼近 softmax 注意力
前文采用过 \phi(x) = \mathrm{elu}(x) + 1,其中
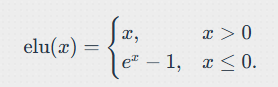
它能保证特征为正,方便构造归一化输出,但定义的是 \sum_a(\mathrm{elu}(q_a)+1)(\mathrm{elu}(k_a)+1)。这种相似度依赖逐坐标非线性变换后的点积,与原始内积的指数 \exp(q^Tk/\sqrt{d_k}) 不同。
Performer 选择了另一条路线:用正随机特征逼近 softmax 归一化前的指数相似度分数。为保留缩放,先令 x=q_i/d_k^{1/4}、y=k_j/d_k^{1/4},于是
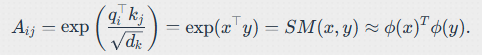
然后有个数学基础, 高斯分布的矩生成函数 : \mathbb{E}_\omega\left[\exp(\omega^\top v)\right] = \exp\left(\frac{\|v\|^2}{2}\right), \quad \omega \sim \mathcal{N}(0, I_{d_k}) 。
高斯积分的证明我没有继续展开,先记住这个结论。T_T。下面只用它推导随机特征的形式。
我们先试试不加修正项,直接让两个指数相乘。
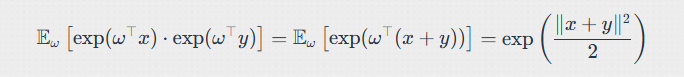
展开之后
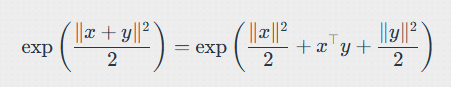
这比我们想要构造的 \exp(x^\top y),在指数里多了 \frac{\|x\|^2}{2} + \frac{\|y\|^2}{2}。 那么接下来的思路就是给每个因子预乘一个只依赖于自身变量的修正项,把多出来的数抵消掉。
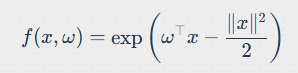
把上面 高斯分布的矩生成函数 : \mathbb{E}_\omega\left[\exp(\omega^\top v)\right] 的 v 代入 v = x + y ,那么
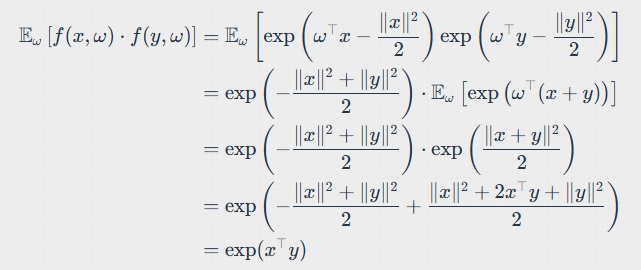
于是这个推导结果就成了
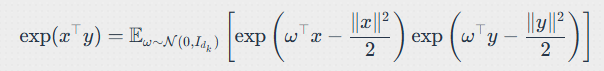
先独立采样 m 个 \omega_1,\ldots,\omega_m \sim \mathcal{N}(0,I_{d_k}),用样本均值近似期望。正交采样的改动稍后再说。
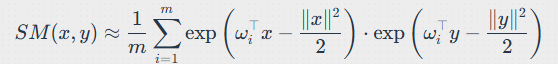
接下来我们定义 m 维向量:
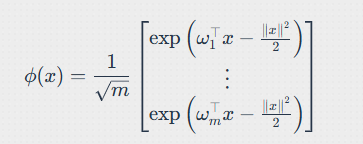
那么有
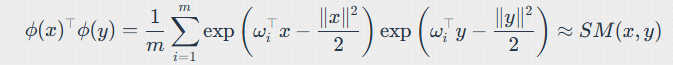
把 m 个行向量 \omega_i^\top 堆叠成矩阵:
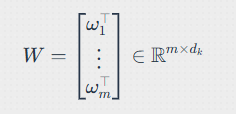
最终得出更紧凑版写法的 \phi(x) 。
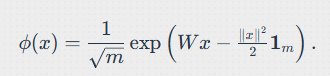
这里的指数逐元素计算。随机投影 W 不通过反向传播训练;学习到的 Q/K 投影仍然会更新。对上面的独立采样估计器,\mathbb E[\phi(x)^T\phi(y)]=\exp(x^Ty),固定 x,y 时方差按 1/m 缩减。
前面的等式表示:固定查询和 Key,把所有可能的随机采样结果按其概率取平均,估计的相似度分数恰好等于真实分数;单次采样仍可能有误差。
但注意力输出还要用估计的分子除以估计的分母,这个比值的平均值未必等于真实的归一化输出。通常 \mathbb E[X/Y]\ne\mathbb E[X]/\mathbb E[Y]。替换已有 Transformer 的注意力后,有限随机特征造成的误差还会跨层传播;论文也讨论了通过微调适应替换后的注意力计算。12
另外,W 不训练也不代表只能采样一次。训练时可以重采样;处理同一段自回归历史时,则要保证查询、Key 和累积状态使用一致的映射,不能换了 W 还直接复用旧状态。Performer 官方实现 也包含动态生成随机投影的例子。
FAVOR+ 的 O(Orthogonal)部分进一步让采样方向正交,以降低估计方差。这里需要同时处理方向和长度:
- 用高斯随机矩阵的 QR 分解等方法生成正交单位方向。
- 若要保持每个 \omega_i 的标准高斯边缘分布,还要乘上服从 \chi_{d_k} 分布的随机长度;只保留单位方向并不够。
- d_k 维空间最多容纳 d_k 个两两正交方向。m>d_k
正交采样后的向量不再相互独立,但可以保持各自的边缘分布。另一种构造把长度固定为 \sqrt{d_k},对应论文中正则化的 softmax 相似度函数(regularized softmax kernel),与上面由标准高斯期望定义的相似度函数不同。12
Performer 仍有近似误差和实现代价:
- 随机特征数 m 决定近似质量与计算量的取舍,有限 m 不能保证精确复现所有注意力分布。
- 后续 FAVOR++、FAVOR# 继续优化随机特征的方差。FAVOR# 在论文报告的相似度分数近似实验中得到过约 e^{10} 倍乃至更大的方差改善。这项数字度量的是相似度分数的估计方差,对应模型的质量与吞吐需要分别测量。
- 单向注意力的计算需要前缀累积,实际吞吐还受注意力计算的具体实现和硬件影响,线性复杂度本身不能保证在所有序列长度上都更快。
另一个方向
Performer 主要解决怎样逼近 softmax 所用的指数相似度函数,固定状态中的写入干扰仍然存在。纯加法更新没有主动遗忘或覆盖旧映射的机制;由于 v_t 可以有正有负,状态范数也并不保证单调增长。
举个假设的例子:如果“苹果(水果)”和“苹果(公司)”在某一层的 Key 很接近,对应的 value 就容易在读出时混在一起。实际的 Key 来自上下文化后的表示,相同词语也可能得到不同方向的 Key。
另一条路线便是直接设计状态的写入和遗忘规则。实际模型也会把这类递推层与 softmax 注意力混用。例如:
- Qwen3-Next-80B-A3B 的 48 层中,36 层是 Gated DeltaNet,12 层是 Gated Attention,比例为 3:1。按其配置,全注意力部分有 16 个 Q 头、2 个 KV 头,属于 GQA;输出门控不改变其中 softmax 注意力的基本性质。
- Kimi Linear 使用 KDA 与 Gated MLA 混合。Kimi K3 的公开配置列出了 69 个 KDA 层和 24 个全注意力层,共 93 层,对应 23 组 [KDA, KDA, KDA, MLA] 后再加一个 MLA 层;最后两层都是 MLA。这里按实际层列表计数,不把论文实验模型和 K3 的配置混用。
- MHA(Multi-Head Attention): 为各查询头配备独立的 K/V 头。
- MQA(Multi-Query Attention): 让所有查询头共享一组 K/V。
- GQA(Grouped-Query Attention): 则让一组查询头共享 K/V。共享程度影响缓存开销和各头能独立生成的 K/V 表示。
- MLA(Multi-head Latent Attention): 使用低维潜变量压缩 K/V,并可通过投影矩阵的组合减少推理时的恢复开销;LoRA 则使用低秩增量进行参数微调。MLA 的定义可参考 DeepSeek-V2 论文。
接下来分别看这些状态更新规则,以及它们怎样实现分块计算。
DeltaNet:写入前先测量当前误差
相关文献: 《Linear Transformers Are Secretly Fast Weight Programmers》
为什么会产生"记忆混叠"误差?
先忽略归一化。展开状态读取:
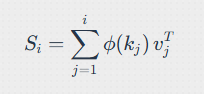
若 r\le i,查询满足 \phi(q_i)=\phi(k_r),则
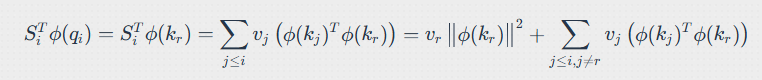
再额外假设映射后的特征 \phi(k_r) 是单位向量,才有 \|\phi(k_r)\|^2=1。原始 k_r 是单位向量并不能保证这一点。于是:
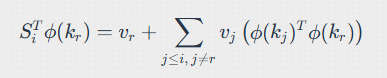
若其他 Key 特征都与 \phi(k_r) 正交,干扰项一定为 0;对某组特定 value,干扰也可能偶然抵消,所以正交是充分条件。若要求对任意 value 都能逐项精确读回,纯外积存储就受到 Key 特征维度的限制:在 d_\phi 维空间里最多只有 d_\phi 个非零的两两正交方向。13
加回归一化,并仍假设 \|\phi(k_r)\|=1:
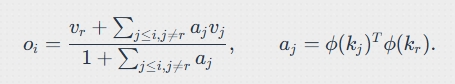
分母只做标量归一化,不能单独去掉其他 value 混入的分量。
Delta 规则:引入可训练的学习率
把 S 看成从 Key 特征到 value 的线性映射,并为当前样本定义重构损失:
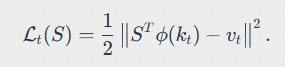
在旧状态 S_{t-1} 上做一步学习率为 \beta_t 的梯度下降,得到
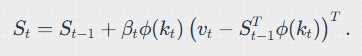
学习率和梯度下降的基本概念可以参考之前的 《大语言模型的基石:Transformer 入坑笔记(二) - 基本原理和 Word Embeddings》。
把旧预测记为
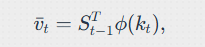
更新就变成
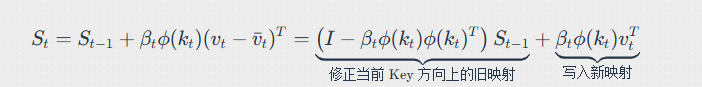
I 是单位矩阵。
它与全局遗忘 S_t=\alpha_tS_{t-1}+\phi(k_t)v_t^T 的区别在于作用方向:标量 \alpha_t 对整个旧状态使用同一个缩放比例,但这个比例也可以由输入决定;Delta 规则则根据当前 Key,修正该 Key 方向上的旧映射。
在后续 DeltaNet 的并行训练工作中,常用的设置还有:
- 对非零 Key 做 L_2 归一化:\hat k_t=k_t/\|k_t\|_2;查询也做相应归一化。省去最初线性注意力公式中的归一化分母,输出使用 o_t=S_t^T\hat q_t,后续还可接输出归一化与门控。
- 每个头的更新强度 \beta_t=\sigma(w_\beta^Tx_t)\in(0,1) 是由输入计算出的标量,而生成它的 权重是可训练的。前面从重构损失推导时,它对应对状态做梯度更新的步长。
当 Key 向量的 L_2 范数为 1 时,有下面的等价关系:
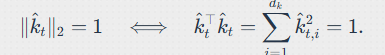
其中 \hat k_{t,i} 是 \hat k_t 的第 i 个分量。沿当前 Key 读回可得
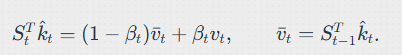
也就是说,读回结果在旧预测与新 value 之间插值,步长不再额外受 Key 范数的平方影响。当其他查询与当前 Key 不正交时,它们的读出也会受本次更新影响。
最终的公式是:
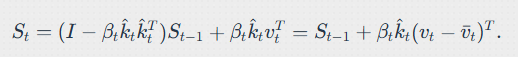
GLA - 面向硬件高效训练的门控线性注意力
相关文献:《Gated Linear Attention Transformers with Hardware-Efficient Training》
线性注意力的并行化
先看省去归一化分母后的线性递推。这一节直接使用投影后的 q_t,k_t,状态为 S_t\in\mathbb R^{d_k\times d_v}:
GLA论文 在这里把额外的特征映射设为恒等映射。 \phi(x)=x \quad\Longrightarrow\quad \phi(q_t)=q_t,\qquad \phi(k_t)=k_t 。
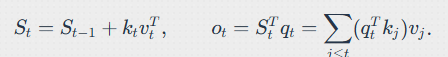
屏蔽未来位置的掩码保留包含对角线的下三角部分,因此矩阵形式为
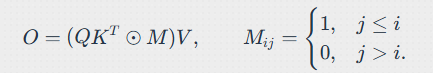
若显式形成 n\times n 的 QK^T,运算量为 O(n^2(d_k+d_v)),注意力矩阵占 O(n^2) 空间。这里按直接生成并保存整张注意力矩阵的方式估算开销;分块实现不必保存整张矩阵。
逐 token 递推的运算量为 O(nd_kd_v),前向只需维护 O(d_kd_v) 的状态。但把公式直接写成循环,训练时也有几个问题:
- 串行依赖链:直接按 token 顺序执行循环时,S_t 要等 S_{t-1} 算完。训练时整段输入已知,却仍逐 token 推进,没有充分利用序列维度的并行性。
- 每步工作量太小:一步主要是外积更新和矩阵向量读出,难以像大块矩阵乘法那样充分使用 Tensor Core。
- kernel 调度开销:若把每步拆成多个小 kernel,调度与状态读写还会增加开销。融合 kernel 能缓解这部分问题,但不自动消除时间依赖。
相当于和GPU的硬件特性对着干,并不能充分利用训练 GPU。
GLA: 按 Key 特征行衰减状态的门控
GLA 用分块计算兼顾并行度和状态大小:块内并行计算,块间传递递推状态。它与前文《大语言模型的基石:Transformer 入坑笔记(四) - 线性注意力(Linear Attention) 的基础》 中的 FlashAttention 有点像,是分块计算,但计算规则不同:FlashAttention 计算精确 softmax 注意力,GLA 计算带门控的线性递推。
块内有和块长 C 的平方的计算;固定 C (通常比较小)后,总运算量仍随序列长度线性增长。
先来看看逐元素遗忘门控:
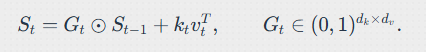
其中 \odot 是阿达玛积(Hadamard product),即逐元素相乘。 例如:\begin{pmatrix}1&2\\3&4\end{pmatrix}\odot\begin{pmatrix}5&6\\7&8\end{pmatrix}=\begin{pmatrix}5&12\\21&32\end{pmatrix}.
为每个 token 直接生成完整 G_t 参数开销很大,也难以得到高效矩阵乘算法。GLA 选择中间粒度,按 Key 特征行衰减:
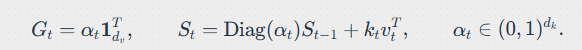
G_t 的每一行恒定,第 a 行所有元素都等于 \alpha_t^{(a)}。因此逐元素相乘 G_t\odot S_{t-1},就是把状态的第 a 行整体乘以 \alpha_t^{(a)},等价于左乘对角阵:
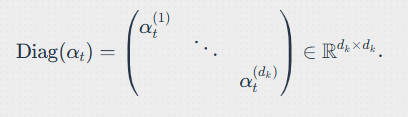
GLA 将门控参数化为
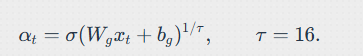
这里是对 sigmoid 的结果取 1/\tau 次幂,等价于将 \log\sigma(z_t) 除以 \tau。15
例如取 z_t=0,不加这个幂次时门值为 0.5,加上后为 2^{-1/16}\approx0.958,同样的 logits 对应更慢的遗忘。这是参数化的数值示例,不代表所有通道初始化时都恰好取这个值。
GLA:工程实践中的优化
这里结合论文与 Flash Linear Attention 的 GLA 实现,看两处与计算有关的处理。
将门控投影拆成两层计算。W_g 拆成两层线性投影 d\to16\to d_k:第一层将输入压缩到 16 维,第二层生成门控所需的 logits。对应的计算为:
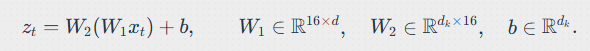
W_1,W_2 是可训练矩阵,b 是可训练偏置向量。低秩分解减少生成门控所需的参数和计算;b 在 logits 上增加一个不随当前输入变化的偏移。
另一处是用 log 值保存门控,通过累积和及区间差值计算衰减,减少直接连乘带来的数值问题:
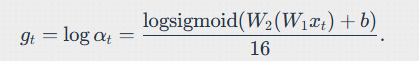
实现还提供可选的门控下界,默认不截断。26 例如设为 -32,只表示单步 \alpha_t\ge e^{-32}\approx1.3\times10^{-14};多步乘积仍可很小,也不能据此保证低精度计算不下溢。
沿用后面示例中的 RMSNorm 输入处理,先计算对数门控值,分块计算的时候使用加法:
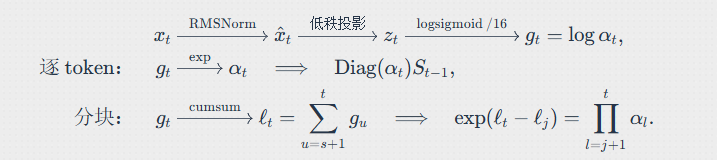
逐步递推时用 \exp(g_t)=\alpha_t;分块计算则用 \ell_t=\sum_{u=s+1}^tg_u,将区间衰减写成 \exp(\ell_t-\ell_j)。
GLA:计算过程举例
举个小例子:单头 Q/K 向量维度为 4,value 维度为 1,输入维度为 3,门控投影的中间维度为 2。
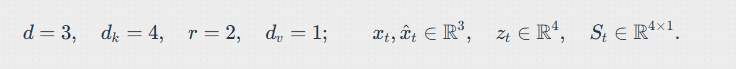
相应地,W_1\in\mathbb R^{2\times3}、W_2\in\mathbb R^{4\times2}、b\in\mathbb R^4。取三个输入 token:
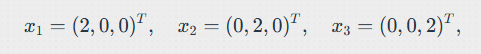
并取门控投影参数
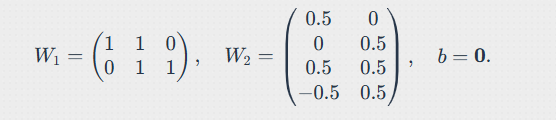
取 RMSNorm 的缩放参数为 1
GLA:示例第 1 步,RMSNorm
取 RMSNorm 的缩放参数为 1,忽略数值稳定项 \epsilon,则 \hat x_t=x_t/\sqrt{\frac13\sum_a x_{t,a}^2},维度仍为 3。RMSNorm 不做均值中心化,不能由它推出各通道均值为 0。
token | $x_t$ | $\hat x_t$ |
|---|---|---|
1 | $(2,0,0)^T$ | $(1.732,0,0)^T$ |
2 | $(0,2,0)^T$ | $(0,1.732,0)^T$ |
3 | $(0,0,2)^T$ | $(0,0,1.732)^T$ |
GLA:示例第 2 步,低秩投影
先投影到 2 维:W_1\hat x_1=(1.732,0)^T、W_1\hat x_2=(1.732,1.732)^T、W_1\hat x_3=(0,1.732)^T。实际模型中,输入维度通常远大于门控投影的中间维度。再计算 z_t=W_2W_1\hat x_t+b\in\mathbb R^4。后面的表格省略向量转置符号。
token | $z_t$ |
|---|---|
1 | $(0.866,0,0.866,-0.866)$ |
2 | $(0.866,0.866,1.732,0)$ |
3 | $(0,0.866,0.866,0.866)$ |
GLA:示例第 3 步,单步对数门值
计算 g_t=\operatorname{logsigmoid}(z_t)/16,得到:
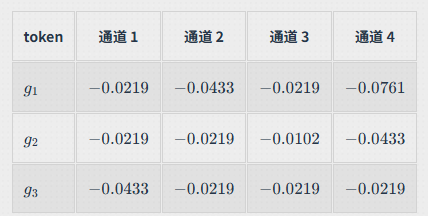
GLA:示例第 4 步,累积对数门值
本例从位置 1 开始累积,\ell_t=\sum_{u=1}^tg_u\in\mathbb R^4。以下均使用未舍入的中间值计算,最后保留四位小数。
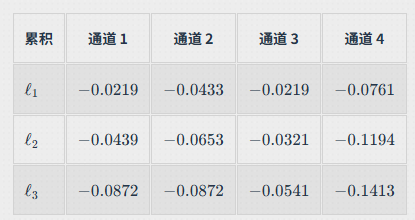
GLA:计算过程举例 - 第 5 步:exp 还原
累积值还原后得到 b_t=\exp(\ell_t)=\exp(\sum_{u=1}^tg_u)=\prod_{u=1}^t\alpha_u,乘积按通道计算:
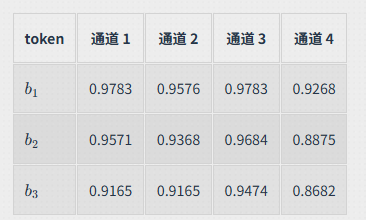
而逐 token 更新状态时,用的是 \alpha_t=\exp(g_t),不能把 b_t 再乘到已经衰减过的 S_{t-1} 上:
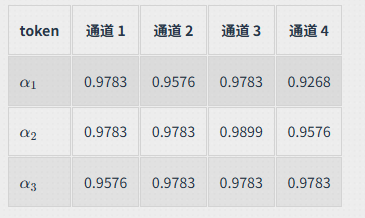
令 S_0=0,再假定写入量 u_j=k_jv_j\in\mathbb R^4 为 u_1=(2,2,2,2)^T、u_2=(4,0,0,4)^T、u_3=(0,3,3,0)^T。这里 d_v=1,可将状态视为四维列向量,逐步更新为:
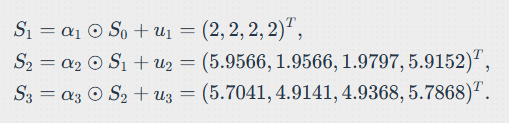
GLA:计算过程举例 - 第 6 步:读出
假设 q_3=(1,1,1,1)^T,那么 o_3=S_3^Tq_3\approx5.7041+4.9141+4.9368+5.7868=21.3418。
这里为方便计算取 d_v=1,一般情况下 o_t 是 d_v 维列向量。多头结构会拼接各头输出,再经 W_O 做线性投影。
GLA: 总结
上面的例子展示的是逐 token 递推。要得到分块算法,还要把历史状态与本块写入分开。设本块从 s+1 开始,定义区间衰减矩阵
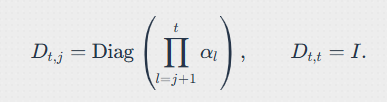
把长度为 n 的序列划分为长度至多为 C 的块(最后一块按实际长度计算)。取整段序列的初始状态 S_0=0,则带门控的输出展开为 o_t=\sum_{j=1}^{t}v_j\bigl(k_j^TD_{t,j}q_t\bigr)。将状态与读出拆成两部分;块内组织成并行矩阵计算,块间传递递推状态。
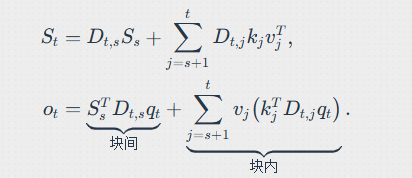
这里 \alpha_l 是向量,门控必须留在点积内部。只有每个通道的衰减相同,才会退化为点积外乘一个标量的形式。
为看出矩阵乘法的结构,在当前块内令 b_t=\prod_{l=s+1}^t\alpha_l,b_s=\mathbf1,则
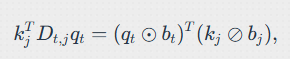
其中 \oslash 是逐元素相除。把重加权后的查询和 Key 堆成矩阵,就能并行算块内的成对权重,再与 V 相乘;块末状态则传给下一块。直接计算 k_j\oslash b_j 仍可能不稳定,所以论文进一步采用 log 空间的差值和二级分块,兼顾数值稳定性与矩阵乘法效率。15
若仅为比较复杂度,令 d_k=d_v=d,忽略输入输出存储,则有:
方案 | 运算量 | 单块或流式前向的额外工作空间 | 计算特点 |
|---|---|---|---|
显式整段并行 | $O(n^2d)$ | $O(n^2)$ | 大矩阵乘法,形成整张注意力矩阵 |
逐 token 递推 | $O(nd^2)$ | $O(d^2)$ | 直接逐 token 计算时,有时间依赖与小规模计算的调度开销 |
分块,块长 $C$ | $O(nCd+nd^2)$ | $O(C^2+Cd+d^2)$ | 块内矩阵运算,块间传递状态 |
GLA 通过一条独立的"门控支路"(低秩投影 W_2 加偏置 b ,经 sigmoid 族激活)把输入 x_t 映射为逐通道遗忘率 \alpha_t,从而把"何时遗忘、忘多快"变成由内容决定的函数。
Mamba-2 / SSD - 基于结构化状态空间对偶性的高效算法
要理解后面的 Gated DeltaNet,还需要看 《Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality》。
只看单头的状态更新核心,并将离散化的写入缩放吸收到 v_t 中,可以写成
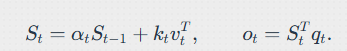
与 GLA 按 Key 特征通道设置门控不同,这里的 \alpha_t\in(0,1) 是每头一个标量,统一缩放该头的旧状态。取 S_0=0,展开后得到
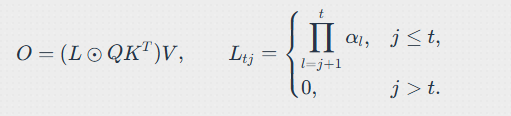
两种形式对这个简化递推严格等价,空乘积取 1。SSD 正是利用这类结构联系状态空间递推与注意力式矩阵计算,并据此设计高效算法。这里讨论的是状态更新核心,完整的 Mamba-2 模块还包含投影、短卷积和输出门控等操作。
Mamba-2 的衰减可概括为
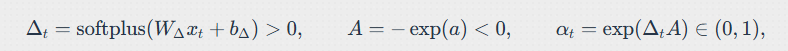
其中 W_\Delta\in\mathbb R^{1\times d_{\rm in}}、b_\Delta,a\in\mathbb R 为每头的可训练参数,A 通过负指数参数化保持为负。Mamba-2 官方实现 的逐步递推还会用 \Delta_t 缩放写入项,前面的简化式将它吸收到了 v_t 中。
\operatorname{softplus}(x)=\ln(1+e^x),其导数是 \sigma(x)=1/(1+e^{-x})。
标量衰减也能用分块计算实现。它与 GLA 一样需要处理块内贡献和前块状态,但各通道共用衰减值,算法结构更简单。接下来的 Gated DeltaNet 就把这种整体遗忘与 Delta 规则结合起来。
GDN: 带门控的 DeltaNet
相关文献:《Gated Delta Networks: Improving Mamba2 with Delta Rule》
这篇是后面 KDA 的重要基础,Qwen3-Next 等公开模型也采用了 Gated DeltaNet。18
回顾前面的 DeltaNet。为简化记号,下面的 q_t,k_t 已完成相应归一化;状态始终使用 S_t\in\mathbb R^{d_k\times d_v}、读出使用 o_t=S_t^Tq_t:
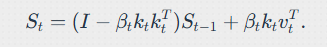
再结合 Mamba-2 式的整体遗忘,就得到 Gated Delta Rule:
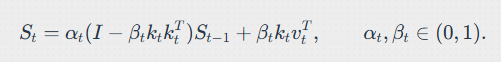
本质上就是对两种算法做了一个结合。那么接下来,我们就是要推导出这个公式的分块计算怎么进行。
令 \widetilde S_t=\alpha_tS_{t-1}、\widehat v_t=\widetilde S_t^Tk_t,有
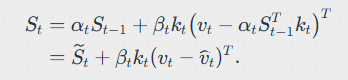
因此它是在整体遗忘之后,用衰减后的状态预测当前 value,再写入预测误差。\alpha_t 控制整体保留多少,\beta_t 控制当前 Key 方向上的修正强度。
接下来把逐 token 更新展开,分别计算前面的块传来的状态和本块各位置的写入。定义
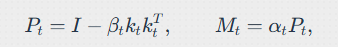
那么递推就是 S_t=M_tS_{t-1}+\beta_tk_tv_t^T。设本块从 s+1 开始,展开前两步:
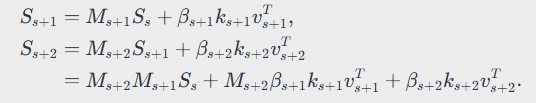
按状态的 左乘更新 约定,矩阵连乘中时间较晚的因子放在左边:
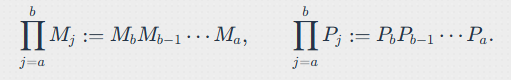
写入位置 i 的贡献,要经过 i+1 到 t 的状态转移才能到达位置 t。按照这个规律继续展开,就得到块间与块内两部分:
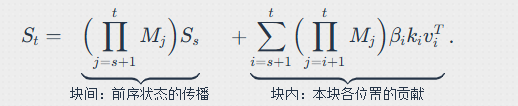
当 i=t 时,后续转移为空,乘积取单位矩阵 I。按全文的列向量约定,读出为:
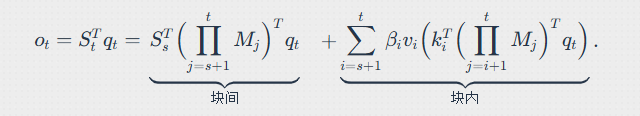
其中 \alpha_j 是标量,可以从矩阵乘积中提出来。令
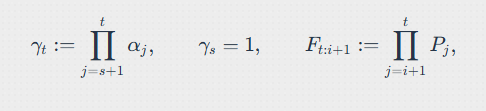
并约定空区间的 F 为 I。于是
代回状态与读出,就有
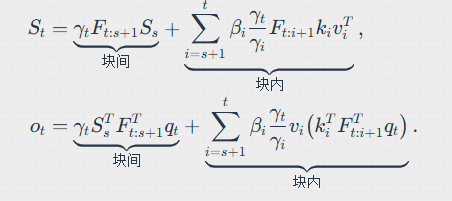
标量衰减已经单独提取出来,接下来要处理的是 d_k\times d_k 的矩阵乘积 F_{t:i+1}。各个 P_j 通常不可交换,计算时要保留顺序。
到这里 Gated DeltaNet的基本公式推导 已经完成了。但是到这里还有几个问题,计算量过大或无法利用显卡并行化。
- 如果把 P_j 当成普通稠密矩阵,仅计算块起点到各位置的前缀乘积,就需要约 C 次矩阵乘法。按常规稠密矩阵乘法每次 O(d_k^3) 估算,这部分是 O(Cd_k^3);块内各次写入还涉及不同起点的区间乘积。
- 如果逐 (i,t) 对的 O(C^2) 次矩阵-向量乘,难以充分使用 Tensor Core。
块内项的下标满足 s\lt i\le t\le s+C。第一个位置有 1 次写入贡献,第二个位置有 2 次,直到最后一个位置有 C 次,因此位置对的数量为
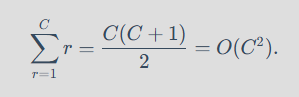
利用结合律,可以先把矩阵乘积作用到 Key 向量上,再与 value 做外积:
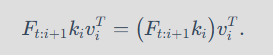
对固定的写入位置 i,记 z_{t,i}=F_{t:i+1}k_i\in\mathbb R^{d_k},那么
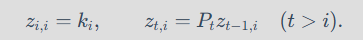
沿着 t 递推,每个新位置对增加一次矩阵向量乘法。若仍按稠密矩阵计算,每次为 O(d_k^2),所有位置对合计 O(C^2d_k^2)。若要形成各位置的完整状态贡献,还要计入外积的 O(d_kd_v),总计为 O(C^2(d_k^2+d_kd_v));当 d_k=d_v=d 时就是 O(C^2d^2)。 这里还可以利用 P_t=I-\beta_tk_tk_t^T 的结构,把单次向量更新进一步化为
只需 O(d_k) 运算。不同写入位置、注意力头和 batch 可以并行,但直接按上述循环计算时,同一写入位置仍要沿时间逐步传播,许多小规模点积与向量更新也难以充分使用 Tensor Core。
因此,论文用 WY 表示与 UT transform,把这些递推组织成块内的三角系统与大块矩阵乘法。下面继续推导它们怎样得到同样的状态与输出。17
Householder 乘积的 WY 表示
接下来将块内位置重新编号为 1,\ldots,C。先构造按右侧追加因子的乘积:
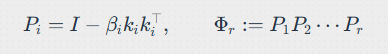
P_i 常被称为广义 Householder 矩阵;这里 \beta_i\in(0,1)。本节为推导 WY 表示,定义 \Phi_r 在右侧追加因子,即 \Phi_r=\Phi_{r-1}P_r。它作用于列向量时,最右侧的 P_r 最先作用。由于每个 P_i 对称,前面左乘递推所需的反向乘积为 F_{r:1}=\Phi_r^T。
\Phi_r 可以写成单位矩阵减去一个秩不超过 r 的修正:
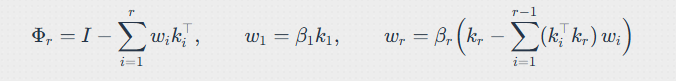
(归纳法)证明过程 如下:
当 r=1 时,显然:\Phi_1=I-\beta_1k_1k_1^{\top},即 w_1=\beta_1k_1。
假设
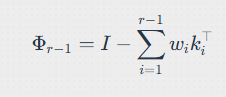
那么有:
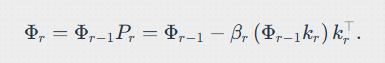
接下来我们展开 \Phi_{r-1}k_r 。
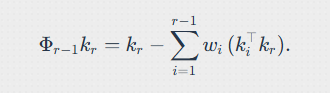
注意系数的结构:k_i^{\top}k_r(只含 k 的内积)乘以已经算好的 w_i。代回并按 k_r^{\top} 项匹配:
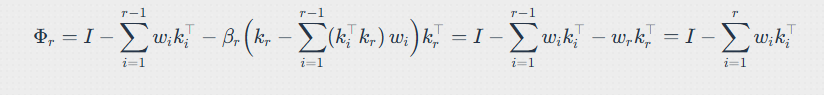
最后一步正是 w_r 的递推式。
到这一步, w_r 的递推仍是逐个算的。接下来可以用 UT transform(Joffrain et al., 2006)把它矩阵化。
UT transform:写成三角求解
把 w_r^T 堆成 W\in\mathbb R^{C\times d_k},把 k_r^T 堆成 K\in\mathbb R^{C\times d_k}。递推式的第 r 行为
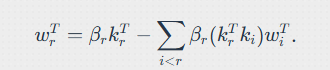
定义严格下三角矩阵 H,与状态矩阵 S_t 区分:
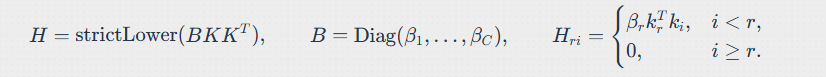
其中,\operatorname{strictLower}(X) 保留 X 主对角线以下的元素,将主对角线及以上的元素设为 0:
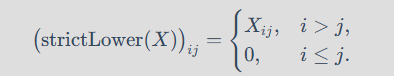
K 按行存放本块 C 个 Key,因此 KK^T 和 H 都是 C\times C 的矩阵,即 H\in\mathbb R^{C\times C}。具体展开为:
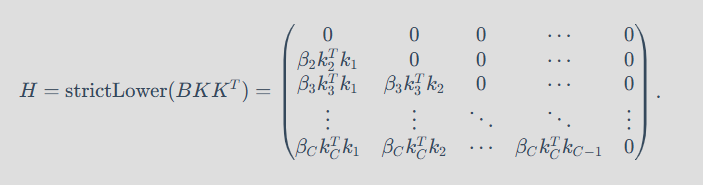
于是整条递推可以写成

即
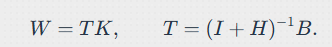
这里是加号,因为移项前是 -HW。这也是 DeltaNet 并行训练论文 式 (10) 和 Gated DeltaNet 论文 第 2.2 节使用的形式。
I+H 是单位下三角矩阵,必然可逆。严格下三角矩阵还满足 H^C=0,因此有代数恒等式
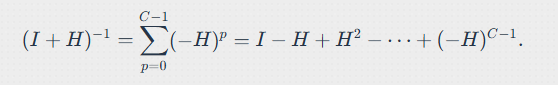
实际实现不需要逐项计算这些矩阵幂。可以做三角求解,或者在固定大小的块内构造变换 T,再将其与 K 相乘。
具体是利用下三角结构,按行解出 T,再用矩阵乘法计算 W。 因为 I+H 的对角线都是 1,求解过程可以写成:
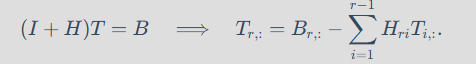
推导过程如下:
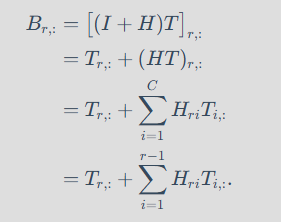
最后一步利用了 H 是严格下三角矩阵:第 r 行只有前 r−1 个元素可能非零,对角线及其右侧都是 0。时间复杂度是 O(C^3) 。 举一个
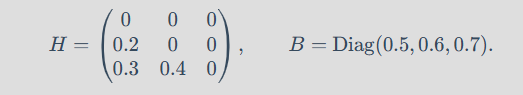
依次计算三行:
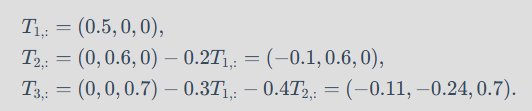
这样就求出了整个 T。每一步只使用前面已经算好的行。
这里的 T[r, :] 表示第 r 行。第一行可以直接得到;第二行使用已经得到的第一行;第三行使用前两行。这就是“前代”,也称前向代入。
代入 Gated DeltaNet 的分块公式
还需要把衰减门控和前块状态一起代入。设前一块结束于位置 s,传入当前块的状态为 S_s;当前块的位置使用原序列下标 r\in\{s+1,\ldots,s+C\}。本块累积衰减为 \gamma_r=\prod_{j=s+1}^r\alpha_j,并约定 \gamma_s=1。
为避免显式形成每一对位置之间的 F,把预测误差乘以更新强度 \beta_r,定义实际写入的残差向量
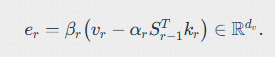
残差就是“目标值减去当前预测值”,表示当前预测还差多少。
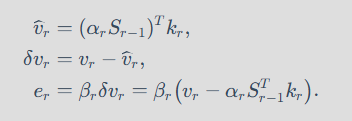
正向推导还原递推如下:
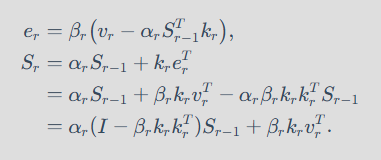
状态便满足 S_r=\alpha_rS_{r-1}+k_re_r^T,展开为
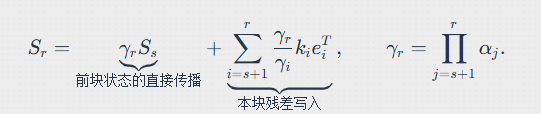
其中的 e_i 包含前块状态带来的预测修正,后面还会按信息来源拆分。将这个展开式用于 S_{r-1},再代回残差定义,得到
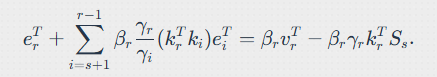
这个推导的目的是:消去中间状态 S_{r-1},建立本块各个残差之间的线性方程组,为后面的三角求解做准备。 先把残差定义转成行向量: e_r^T =\beta_r\bigl(v_r^T-\alpha_rk_r^TS_{r-1}\bigr). 再把状态展开式用于前一个位置:
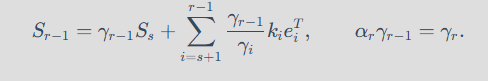
将它代入残差定义,并展开括号:
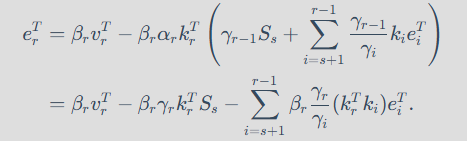
最后,把包含此前残差的求和项移到左边,就得到上面的公式。
这构成一个单位下三角线性系统:求和只涉及更早位置的残差。
下面的 Q,K,V,B,H,T 均按本块数据构造;矩阵行列号使用 u,v\in\{1,\ldots,C\},例如 K 的第 u 行为 k_{s+u}^T。定义
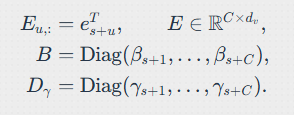
区间衰减和两个严格下三角矩阵分别为
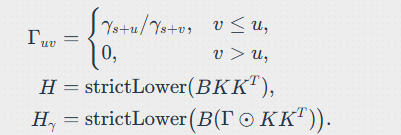
\Gamma 包含对角线,对角线上的衰减比例为 1,供后续读出使用。构造 H_\gamma 时,\operatorname{strictLower} 去掉对角线,保留的系数恰好对应原式中的 i\lt r:
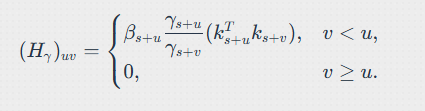
把各位置的残差方程按行堆起来,得到
这里的 H 就是前面定义的 H=\operatorname{strictLower}(BKK^T),H_\gamma 在它的基础上加入区间衰减。由于 H_\gamma=D_\gamma HD_\gamma^{-1},且 B 与 D_\gamma 都是对角矩阵,可以复用前面求出的 T=(I+H)^{-1}B:
(H_\gamma)_{uv} =(D_\gamma HD_\gamma^{-1})_{uv} =\frac{\gamma_{s+u}}{\gamma_{s+v}}H_{uv}. 左乘对角矩阵会缩放各行,右乘对角矩阵会缩放各列,因此每个元素乘上对应的区间衰减比例。
根据 H_\gamma 的定义,可以把左侧的系数矩阵分解为
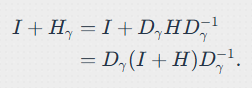
于是
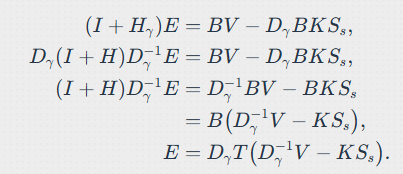
有了 E,整块输出和块末状态都只需矩阵乘法与逐元素缩放:
注意和上面 S_r= \gamma_rS_s + \sum_{i=s+1}^r\frac{\gamma_r}{\gamma_i}k_ie_i^T 的 k_i e_i^T 的差异。这里 K 的第 u 行为 k_{s+u}^T ,E 的第 u 行是 e_{s+u}^T ,都已经进行了转置。 S_{s+C} 可以用上面残差的递推公式推导出来。O_{\rm chunk} 的推导过程如下。 本文按行存放输出,因此单个位置的读出写为:
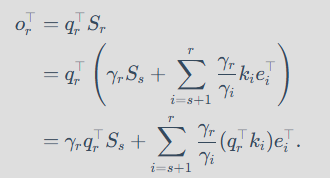
这里的含义是:当前 Query 分别与各位置的 Key 做点积,再用点积和区间衰减加权对应的残差。 接下来将这两项分别写成矩阵形式。设矩阵第 u 行对应原序列位置: r=s+u (Query 与 Key 的点积是标量)
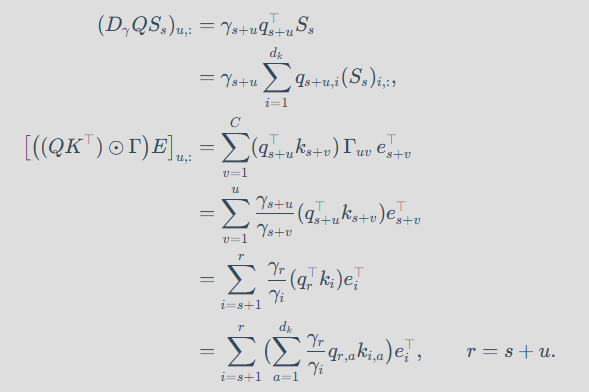
如果只看第 j 个输出分量,则进一步展开为:
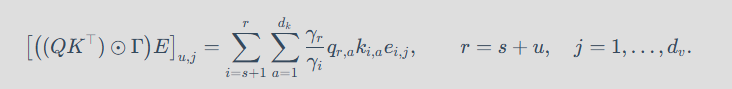
上面第一组 q_{s+u}\in\mathbb R^{d_k},\qquad S_s\in\mathbb R^{d_k\times d_v},\qquad q_{s+u}^{\top}S_s\in\mathbb R^{1\times d_v}. ,所以 q_{s+u}^\top S_s 是 1 \times d_v 的行向量。 而第二组都是向量,q_{s+u}^\top k_{s+v} 乘完是标量,而最后的 E 矩阵其实就是残差转置后的堆叠,所以看起来表达形式有一些差异。
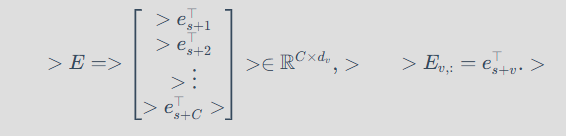
所以最终 \boxed{ O_{\rm chunk} =D_\gamma QS_s+\bigl((QK^\top)\odot\Gamma\bigr)E}
其中 O_{\rm chunk}\in\mathbb R^{C\times d_v},第 u 行是 o_{s+u}^T;块末状态 S_{s+C}\in\mathbb R^{d_k\times d_v} 传给下一块。
要与前面的展开式一样,按信息来自前块还是本块划分贡献,还需要展开 E 对 S_s 的依赖。定义
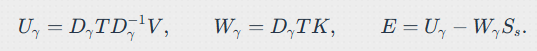
U_\gamma\in\mathbb R^{C\times d_v} 是仅由本块输入决定的部分,W_\gamma\in\mathbb R^{C\times d_k} 给出前块状态带来的预测修正。再记
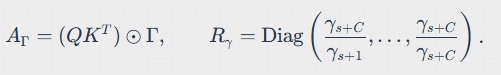
代回输出与块末状态,将所有包含 S_s 的项放在一起:
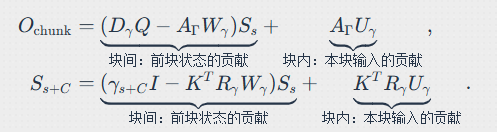
为便于对照这两式,将本节用到的矩阵定义和维度汇总如下。仍按单个注意力头计算,C 是块长,d_k 是 Query/Key 的特征维度,d_v 是 Value 与残差的维度;矩阵行列号 u,v\in\{1,\ldots,C\} 对应原序列位置 s+u,s+v。每个位置的 \alpha_r,\beta_r 都是标量,累积衰减与写入残差为
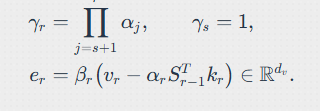
输入、状态及衰减矩阵按以下方式组织。其中 Q,K,V,E 都按行堆叠对应的列向量转置:
矩阵 | 形状 | 定义与含义 |
|---|---|---|
$Q$ | $C\times d_k$ | $Q_{u,:}=q_{s+u}^T$,本块 Query |
$K$ | $C\times d_k$ | $K_{u,:}=k_{s+u}^T$,本块 Key |
$V$ | $C\times d_v$ | $V_{u,:}=v_{s+u}^T$,本块目标 Value |
$S_s$ | $d_k\times d_v$ | 前一块结束时的状态,作为本块输入 |
$E$ | $C\times d_v$ | $E_{u,:}=e_{s+u}^T$,本块实际写入的残差 |
$B$ | $C\times C$ | $\operatorname{Diag}(\beta_{s+1},\ldots,\beta_{s+C})$,逐位置的更新强度 |
$D_\gamma$ | $C\times C$ | $\operatorname{Diag}(\gamma_{s+1},\ldots,\gamma_{s+C})$,块起点到各位置的累积衰减 |
$\Gamma$ | $C\times C$ | $\Gamma_{uv}=\gamma_{s+u}/\gamma_{s+v}$($v\le u$),$v>u$ 时为 0;包含对角线的区间衰减 |
三角求解与最终拆分所用的矩阵为:
矩阵 | 形状 | 定义与含义 |
|---|---|---|
$H$ | $C\times C$ | $\operatorname{strictLower}(BKK^T)$,未加入衰减的残差依赖系数 |
$H_\gamma$ | $C\times C$ | $\operatorname{strictLower}\bigl(B(\Gamma\odot KK^T)\bigr)$,加入区间衰减的残差依赖系数 |
$T$ | $C\times C$ | $T=(I+H)^{-1}B$,等价于求解 $(I+H)T=B$ |
$U_\gamma$ | $C\times d_v$ | $D_\gamma TD_\gamma^{-1}V$,残差中仅由本块输入决定的部分 |
$W_\gamma$ | $C\times d_k$ | $D_\gamma TK$,前块状态对残差的预测修正系数 |
$A_\Gamma$ | $C\times C$ | $(QK^T)\odot\Gamma$,包含因果掩码和区间衰减的读出权重 |
$R_\gamma$ | $C\times C$ | $\gamma_{s+C}D_\gamma^{-1}$,将各位置的残差写入衰减到块末位置 |
其中 \operatorname{strictLower} 只保留主对角线以下的元素;定义 T 时的 I 是 C\times C 单位矩阵,块末状态公式中的 I 则是 d_k\times d_k 单位矩阵。残差矩阵整体由
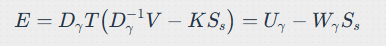
求得,因此它同时依赖本块输入和前块传入的状态。最终 O_{\rm chunk}\in\mathbb R^{C\times d_v} 按行存放本块输出,S_{s+C}\in\mathbb R^{d_k\times d_v} 传给下一块。
由 R_\gamma D_\gamma=\gamma_{s+C}I 和前面的 WY 表示,块间状态的系数还可还原为
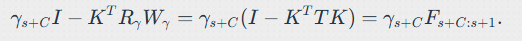
这与最初按矩阵乘积展开得到的前块状态传播一致。块内求解与输出计算不再逐 token 更新,块间仍需递归传播。
这些公式即是 GDN论文 分块的算法与递推的对应关系;实际 kernel 还要在 log 空间处理衰减、避免极小 \gamma_i 的直接求逆,并安排融合、重计算与内存访问。17 取 \alpha_t=1 时退化为 DeltaNet。
这一章写得很长,是因为我个人之前主要领域是分布式系统,和AI比较遥远,很多线性代数的知识都还给老师了,这里面很多内容其实是重拾回顾了一些矩阵运算的基本定理和公式。算是把之前一些理解上的不清楚的点也一一趟平了。到这里也就可以比较容易地写出这个分块实现了。
KDA: Kimi Delta Attention
相关文献:《Kimi Linear: An Expressive, Efficient Attention Architecture》
终于到最后一部分了,截至我看这篇Paper的时间点,后续更给力的大模型也出来了。不过 KDA 的核心思想还是很值得借鉴的,无论 KDA 还是后续 Qwen 的 LLM,很多也是在 GDN 的基础上在各个更细分的地方继续优化。
GDN 的主要思想是结合 Mamba-2 和 DeltaNet 。通过前文我们知道 Mamba-2 是标量的记忆衰减。那表达力更强的 GLA 的按Key 特征行衰减有更好的表达力,和 DeltaNet 结合怎么样呢?这也就是 KDA 的核心思想。
前面基本的线性注意力、DeltaNet 和 GLA 的公式我就不重复贴了。KDA 的最终整合之后的基本公式如下:
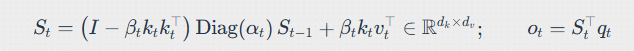
然后接下来就是要把这个公式展开为能够高效利用硬件并行计算的分块算法。
KDA分块计算推导
为了方便理解,我们不用论文里的表达方式,而是用和前面论文推导一致的表示方式。
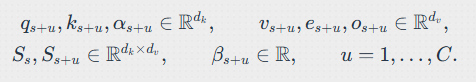
这里的向量都是列向量,块矩阵按行存放它们的转置。然后先把单步更新改写为衰减后的旧状态,加上残差写入:
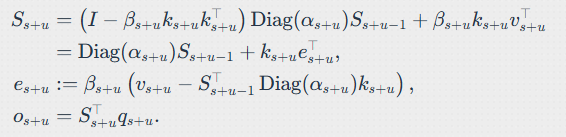
接下来定义当前块的逐通道累计衰减。其中 \odot 表示逐元素乘法,\oslash 表示逐元素除法:
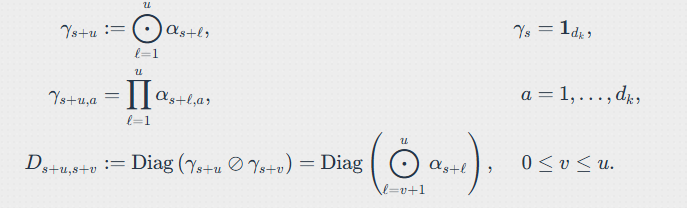
这里的除法要求 \gamma 的各分量非零;直接对很小的累计衰减取倒数也会有数值稳定性问题,论文 §3.2 讨论了 log 域与二级分块处理。5
与 Gated DeltaNet 不同,这里的累计衰减是一个向量。将残差形式逐步展开。前两步能直接看出每次写入经过了哪些衰减:
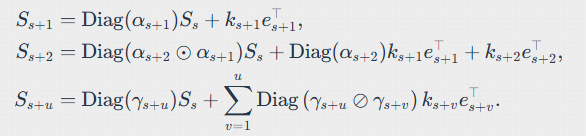
然后将上面的展开式用于前一个位置,再乘当前门控,消去残差定义中的中间状态。
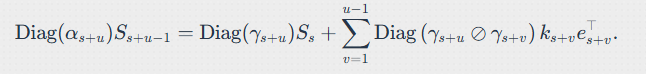
把它代入残差的行向量表达式:
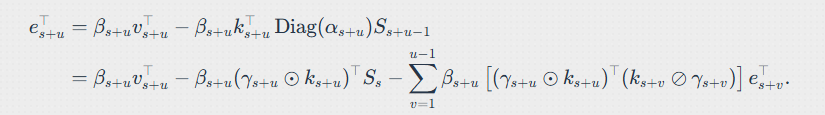
这样就消除了中间状态,只剩下起始块s和最终的s+u的关系。
对应 WY 表示的辅助递推(原文式 4–5)。 原文分别递推 w_r,u_r;本文改为递推合并后的 e_{s+u}。 将原文块内位置 r 对应到文档的 s+u,有 e_{s+u}^{\top}=u_{s+u}^{\top}-w_{s+u}^{\top}S_s ,或者写成列向量形式 e_{s+u}=u_{s+u}-S_s^{\top}w_{s+u} 。 原文的递推流程要参考前面 GDN: 带门控的 DeltaNet 中的 Householder 乘积的 WY 表示 。P_i = I-\beta_ik_ik_i^{\top},\qquad \Phi_r := P_1P_2\cdots P_r 时, \Phi_r 可以表达为 \Phi_r = I-\sum_{i=1}^{r}w_ik_i^{\top},\qquad w_1=\beta_1k_1,\qquad w_r=\beta_r\Big(k_r-\sum_{i=1}^{r-1}(k_i^{\top}k_r)\,w_i\Big) 。 在 KDA的论文 里,w_r 还多带上了 \operatorname{Diag}(\gamma_{s+u}) 。 这个关系可以直接比较两种状态展开得到。推导如下: 为简化下标,把块内位置 s+u记为 r,并定义
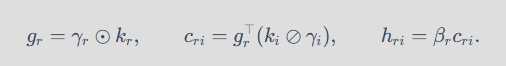
文档中的残差递推于是写成
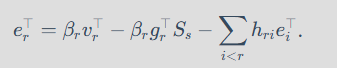
原文 WY 表示中的两组辅助递推分别是
现在对更早位置使用 e_i^\top = u_i^\top - w_i^\top S_s,代入残差递推:
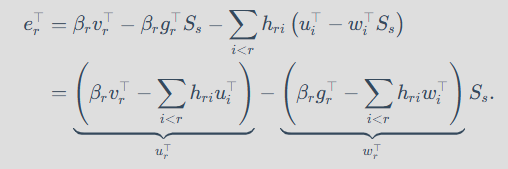
所以 \boxed{e_r^{\top}=u_r^{\top}-w_r^{\top}S_s}.
接下来我们把上述逐位置递推堆成三角系统,再用一次三角变换同时求出辅助矩阵。
对应原文的 UT 变换(式 6–7)。
我们还是用和前面一样的堆叠方式定义矩阵。
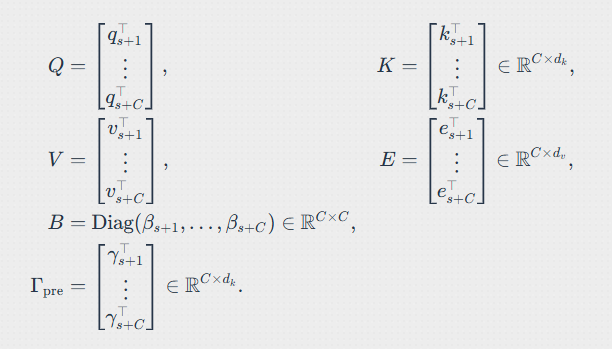
残差之间的依赖系数还是构成严格下三角矩阵:
$$ \begin{aligned} H_\gamma &:=\operatorname{strictLower}\left( B(\Gamma_{\mathrm{pre}}\odot K) (K\oslash\Gamma_{\mathrm{pre}})^{\top} \right) \in\mathbb R^{C\times C},\\ (H_\gamma)_{uv} &= \begin{cases} \displaystyle \beta_{s+u}\sum_{a=1}^{d_k} \frac{\gamma_{s+u,a}}{\gamma_{s+v,a}} k_{s+u,a}k_{s+v,a}, &v那么将残差项移到左侧,再将各行堆起来,就有
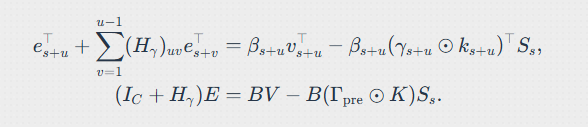
然后进行三角求解。将本节的三角变换记为 T_\gamma:
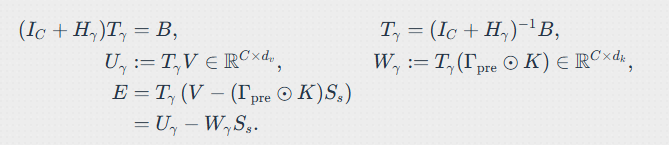
这就得到了目标公式中的“伪值”项:它正是整块实际写入的残差。两个辅助矩阵只依赖本块输入;传入状态到达后,就能求出残差矩阵。 逆矩阵写法用于表达代数关系,实现时可以直接三角求解。(前文 GDN: 带门控的 DeltaNet 中的 UT transform:写成三角求解 章节有证明过程。)
将 UT 结果代回 WY 状态展开,对应原文式 (8)。 这里不再引入新的变换,而是使用 E=U_\gamma-W_\gamma S_s 得到块末状态。
我们单独定义矩阵
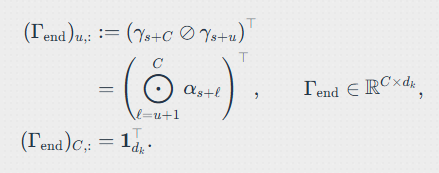
那么对于一个分块的最后的状态
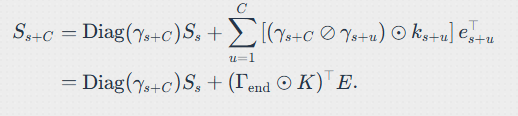
对于输出,先写单个位置输出的转置:
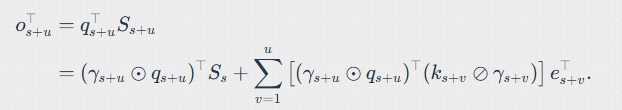
方括号内是一个标量,表示当前 Query 对某次残差写入的读出权重。将这些权重组成矩阵,再保留包含对角线的下三角部分:
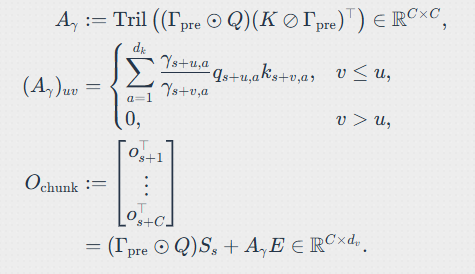
与 GDN: 带门控的 DeltaNet 中的 \Gamma 一样,这里保留对角线,是因为单步读出使用的是完成当前写入后的状态,所以当前位置也要读到自己的残差。
进一步展开到单个输出分量,可以直接看到两层求和:
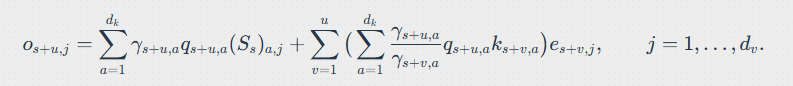
其中,内层对 Key/Query 特征维度求和,外层对可见的块内位置求和。
KDA的分块计算最终状态和输出
将残差矩阵代回,得到最终的块末状态更新:
和输出
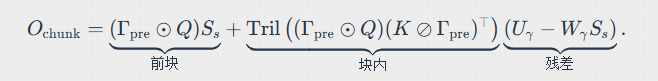
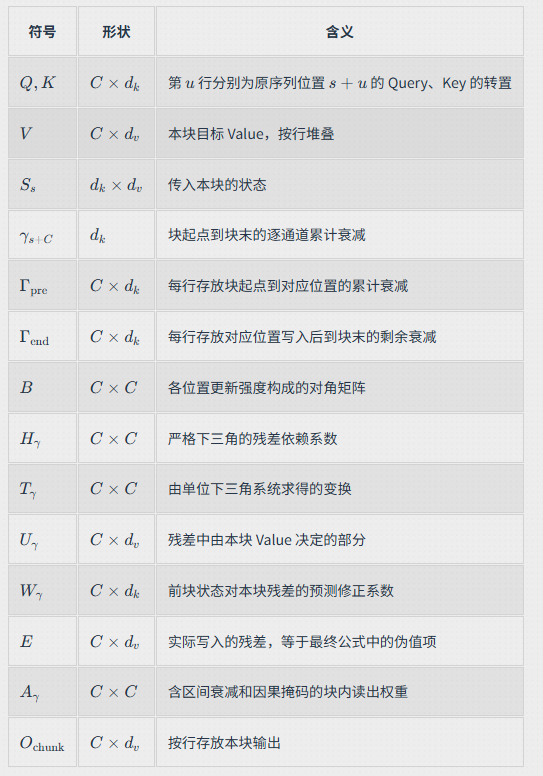
KDA推导过程的矩阵定义与维度汇总
到这里, KDA 的推导和整个计算公式就完成了。
KDA的实验数据
每个算法都有各自的对比数据来展示单算法的优势和提升。这里就不重复贴了。
Kimi Linear 最终采用 KDA 与 MLA 按 3:1 混合的架构。 概念上,MLA 是“保存历史 KV,查询时重新选择”,KDA 是“把历史压进固定状态,并逐步衰减和改写”。
- KDA:把历史压缩进固定大小的状态。自回归解码时,单 token 的递推计算量和状态存储不随历史长度增长;预填充总计算量仍随序列长度线性增长。它适合承担大多数层,但压缩可能丢失细节,精确复制、长距离内容寻址仍受有限状态容量限制。
- MLA:保留每个 token 的压缩 KV,查询仍能直接访问历史位置,全局精确寻址更强。代价是标准全注意力预填充包含 O(T^2) 项,解码每个新 token 需访问 O(T) 的历史 KV,KV cache 也随长度以 O(T) 增长;它虽然比 MHA 更省缓存,但长上下文下的注意力计算开销仍较高。
混合的目的,就是让 KDA 承担大部分序列建模,再由周期性 MLA 补回直接访问历史的能力。具体配比的消融结果如下。(实验使用 16 头、16 层的 scaling-law 模型,各配置采用相同的 FLOPs 预算和超参数。)5
配置 | Training PPL (↓) | Validation PPL (↓) | 说明 |
|---|---|---|---|
混合比 3:1(最终采用) | 9.23 | 5.65 | 该消融中的最佳折中 |
0:1(纯全注意力) | 9.45 | 5.77 | 该训练设置下损失更高 |
1:1 | 9.29 | 5.66 | 验证损失接近,MLA 层更多 |
7:1 | 9.23 | 5.70 | 表列训练 PPL 相同,验证 PPL 稍高 |
15:1 | 9.34 | 5.82 | 验证损失进一步升高 |
去掉输出门 | 9.25 | 5.67 | 该设置下困惑度升高 |
换 Swish 输出门 | 9.43 | 5.81 | 该设置下不如 Sigmoid |
去掉卷积层 | 9.29 | 5.70 | 该设置下困惑度升高 |
这组数据中,3:1 是较好的折中,论文最终也选用了它。
附录
Kimi Linear 表 6:注意力机制的递推形式与并行形式
KDA论文 §6.1 的表 6 汇总了不同注意力机制的递推形式 o_t 和并行形式 O,方便对照。下表按原表转写,沿用本文的列向量与转置习惯;KDA 行递推顺序的修正见表后说明。
原表为简化表达,省略了归一化项和更新强度 \beta_t,所以这些公式用于比较结构,不是各算法的完整定义。原表中的 \phi 是指数核的无穷维特征映射,满足 \phi(q)^T\phi(k)=\exp(q^Tk)。
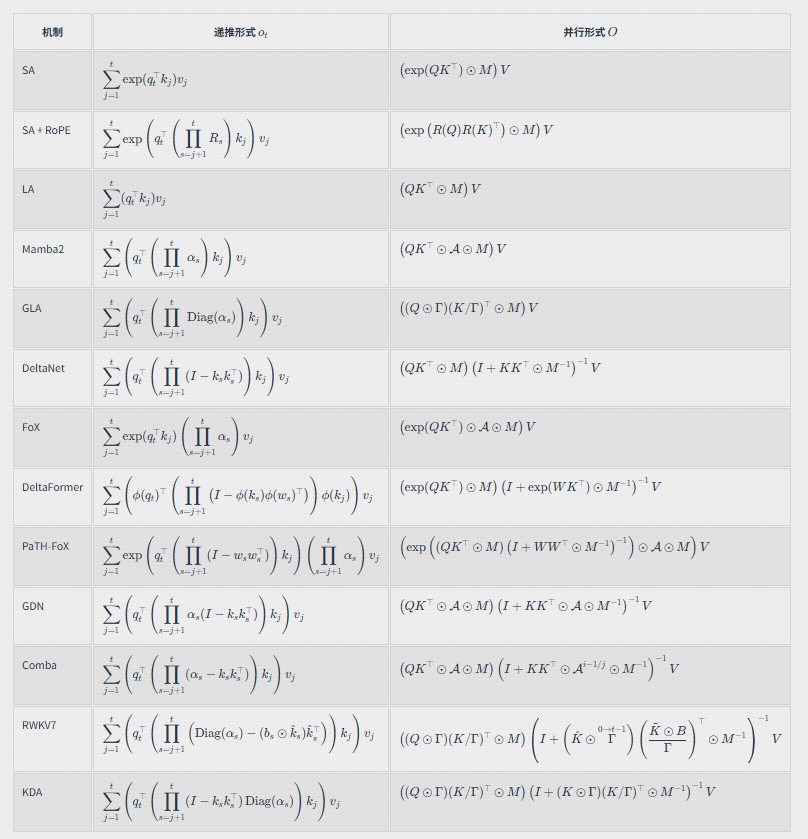
上面表的符号和我们推导用的名字可能有一些差异。请注意区分。原表 KDA 行的递推乘积顺序与论文式 (1) 不一致,上表已按式 (1) 调整。
和DPLR的关系
KDA论文 §6.2 提到,(Gated) DeltaNet 可以泛化为更有表达力的 Diagonal-Plus-Low-Rank(DPLR)结构。这里的意思是:DeltaNet 和 Gated DeltaNet 的状态转移矩阵,都可以看作 DPLR 矩阵家族的特例。
只比较状态转移部分,将递推写成
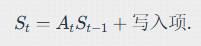
DPLR 将转移矩阵写成
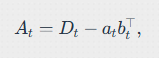
其中 D_t 是对角矩阵,负责逐特征通道缩放;a_tb_t^\top 是向量外积,因此是秩 1 矩阵,负责不同特征方向之间的修正。低秩部分也可以扩展为秩 r,这里主要讨论秩 1。
DeltaNet、Gated DeltaNet 和 KDA 都能写成这种形式:
机制 | $D_t$ | $a_t$ | $b_t$ |
|---|---|---|---|
DeltaNet | $I$ | $\beta_tk_t$ | $k_t$ |
Gated DeltaNet,标量 $\alpha_t$ | $\alpha_tI$ | $\beta_tk_t$ | $\alpha_tk_t$ |
KDA,向量 $\alpha_t$ | $\operatorname{Diag}(\alpha_t)$ | $\beta_tk_t$ | $k_t\odot\alpha_t$ |
一般 DPLR | 任意对角矩阵 | 可独立参数化 | 可独立参数化 |
例如 KDA 的状态转移可以展开为
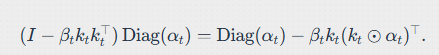
因此,KDA 的状态转移也是一种 DPLR 结构。论文利用这种约束减少通用 DPLR 的计算量,同时保留逐通道遗忘和 Delta 纠错能力。
最后
到这里,我们就完成了从LLM基础原理到成熟产品(Kimi K3)间关于注意力的完整原理解析和论证过程。 本文优化涉及的论文很多,我自己也是抽空慢慢看,并且过程中补充了各个涉及公式的推导和证明过程,看完的时候Kimi K3.1 Pro都发布了。并且K3又落后于第一梯队的最新模型的 GPT 6 Astra和 Claude Opus 5.5一档了。
当然后面实际上还有一些其他的优化方向,比如 LoRA、Looped Transformers、Recursive self-improvement (RSI) 等等。以后再慢慢看了。
我本人并非 AI 领域从业者,可能有理解不到位的地方,欢迎指正。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号