Prompt越长越好吗?研究告诉你何时该停手

关注腾讯云开发者,一手技术干货提前解锁👇
遇到一次失败,就补一条要求;担心遗漏,再加一轮自检;让 LLM 优化,又得到一份更长的说明。提示词常常这样越写越长,但新增的文字,究竟解决了什么问题?
指令并非越长越好,也并非越短越好。 必要条件要补齐,重复与冲突要清理,专用资料要在需要时可达。现有研究没有给出通用的最佳字数,但能帮助我们判断这三类改动是否值得。
本文主要面向编写系统指令、Skill 和工作流的同学,重点讨论带工具、多步骤执行的 Agent。下面先给出修改方法,再解释研究依据;研究结果的适用范围以各自任务与实验设置为准。
01
先分清:到底是什么变长了?
指令告诉模型做什么、遵守哪些要求;完整上下文还包括历史对话、工具说明与返回资料。Skill 是可按任务加载的指令与资料包。一个 Agent 可能多次调用模型,每次带入的内容也不同。
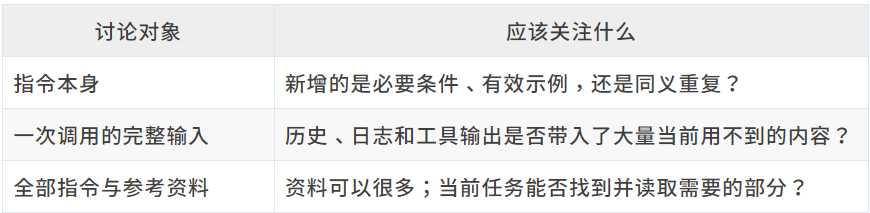
例如,把指令从 500 字补到 800 字,同时加入验收条件,即使效果提高,也不能说明“多写 300 字”本身有益。删除文字时若删掉必要例外,效果变差同样不能证明短指令不好。比较长短之前,先看任务规格和信息内容是否也变了。
模型标注的上下文窗口表示可容纳的规模,不保证窗口内的每条规则都能稳定执行。token 与中文字符数不能固定换算;讨论研究时,应保留原始计量单位。
02
什么时候该补、该删、该按需加载?
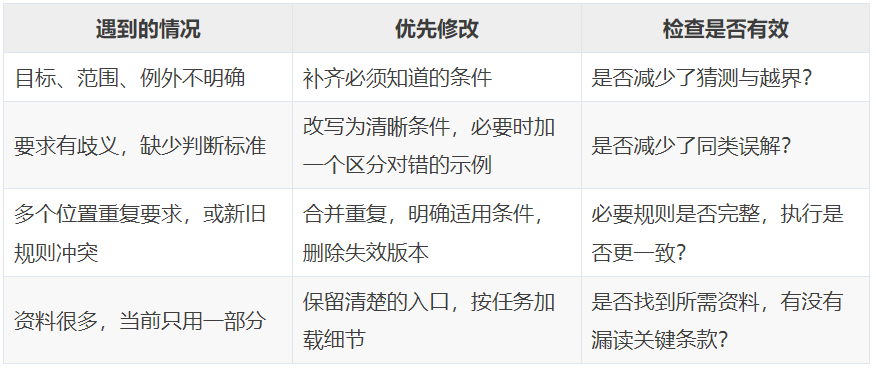
先定位失败,再决定改动篇幅。可以依次问:模型缺少必要条件吗?同一要求是否重复或冲突?这些资料是否每个任务都需要?
一个日志分析的修改示范
假设问题是“模型给出了根因,但没有日志证据”,下面三种写法增加的信息并不相同。以下仅为写法示例,并非已经验证的实验结果。
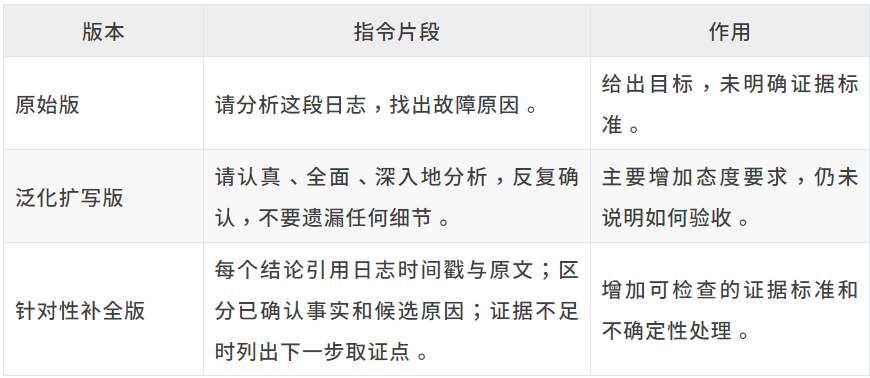
第三版是否更好,要看它有没有减少无证据断言。如果实际遗漏的是服务范围或时间范围,就应该补对应条件;如果选错了组件流程,就应该改善资料入口。修改应落在导致失败的具体条件上。
删减时也要保留条件之间的关系。“满足 A 时执行 B,否则执行 C”不能简化成“执行 B”。精简应减少表达冗余,同时保留必要边界、例外和可执行含义。
03
研究与官方实践,分别支持哪些判断?
下述证据分别改变了上下文、指令内容或资料组织方式,并非统一的纯长度对照。没有通用最佳长度,不代表长度没有影响。 它意味着我们需要区分内容变化、输入规模与任务复杂度,并把实验结果、官方工程观察和规范建议分开理解。
补:长输入中,明确清单仍可能有帮助
代码审计研究 When and How Context Rot Appears in Coding Agents 固定任务与 24 项检查,比较 Codex + gpt-5.4-mini 在不同上下文中的表现,并在相关长上下文上加入不同自检要求。原论文(https://arxiv.org/abs/2607.17937v2)
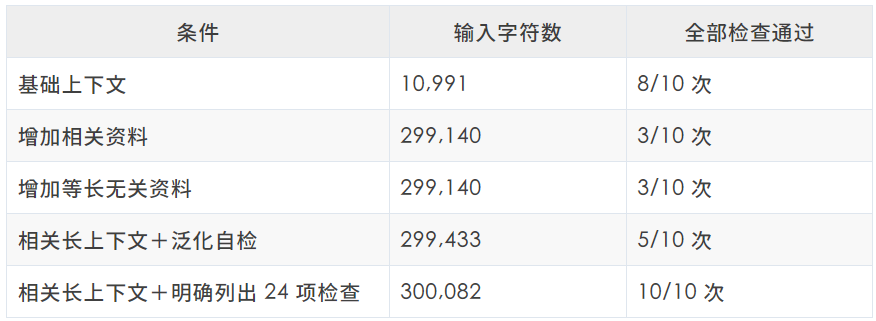
这个结果值得注意:大量增加上下文时,通过次数下降;继续加入明确检查清单时,通过次数又提高。泛泛要求“全面检查”和重新列清必要检查项,作用可能不同。
但每组只有 10 次,另一个审计任务在所测条件下全部通过,仍属需要复现的小样本证据。基础组与两种长输入组分别比较的双侧 Fisher 检验 p=0.0698;明确清单与泛化自检比较的 p=0.0325。不能把 10/10 次通过理解为未来必然可靠。
因此,跨很多步骤仍必须遵守的要求,可以尝试在相关决策点用短清单提醒,再验证是否减少关键遗漏。重复不必一律删除,但也不值得无差别保留。
删:旧规则需要随着模型与流程变化重新验证
Anthropic 2026 年 7 月 24 日的官方文章报告:针对 Claude Opus 5、Fable 5 等更先进模型,Claude Code 移除了超过 80% 的 system prompt,内部编码评测未出现可测损失。删减涉及跨层重复、过时绝对规则,以及可移入 Skill 的专用流程。官方工程观察 · Claude 5 上下文工程(https://claude.com/blog/the-new-rules-of-context-engineering-for-claude-5-generation-models)
可借鉴的是定期检查每条规则是否仍在解决真实问题。模型或工作流升级后,旧限制可能失效;同一要求分散在系统指令、Skill 和用户请求中,也可能变得难以维护。业务事实、权限边界和验收条件,则仍要按实际任务保留。
这是特定产品和内部评测下的工程观察,不能据此建议所有提示词都删掉 80%。保留或删除规则,应以自己的任务结果为依据。
按需加载:入口要清楚,层级要有收益
假设资料库有数十份故障手册。入口可以说明各组件的适用问题与资料位置,执行时再读取相关流程。资料总量没有减少,但某次调用需要处理的内容可以更集中。效果取决于能否找到正确资料,以及关键条款是否在执行前被读取。
Progressive Disclosure 研究在 InfiniteBench 长文问答中,比较原文导航、Skill 资料组织和检索器,覆盖三种执行框架与三类模型。单本书场景的收益依赖框架;多书场景中,一层披露更稳,增加第二层路由没有收益,有时损害准确率。预印本 · 2026-07-20(https://arxiv.org/abs/2607.17598)
这支持先改善信息入口,再评估是否需要更多层级。它研究的是特定资料组织方案,不能外推成任何资料库都只能有一层,也不能推出“拆得越碎越好”。
OpenAI 的工程文章介绍了工具与 Skill 的延迟发现,以及默认 10,000 token 的工具输出上限。这些做法控制每次实际加载的内容;该上限是实现选择,并非模型的有效长度界限。官方工程观察 · 2026-07-29(https://openai.com/zh-Hans-CN/index/gpt-5-6-frontier-intelligence-efficiency/)
还要区分加载与缓存:缓存可以减少重复处理开销,但缓存命中不代表无关内容已经移出上下文。输入长度、计费用量和任务质量需要分别观察。
Agent Skills 规范建议正文低于 5,000 token、主文件少于 500 行;OpenAI 的一项工程实践使用约 100 行 AGENTS.md 作为知识目录。这些数字是组织建议或案例,可以借鉴“入口简洁、细节可达”,不能当作性能最优点。Agent Skills 规范(https://agentskills.io/specification);OpenAI · Harness engineering(https://openai.com/zh-Hans-CN/index/harness-engineering/)
04
落到系统指令、Skill 和工具说明,怎么分配内容?
下面是依据前述证据与实践整理的写法建议。分配内容时,既要看使用频率,也要看规则何时必须生效。
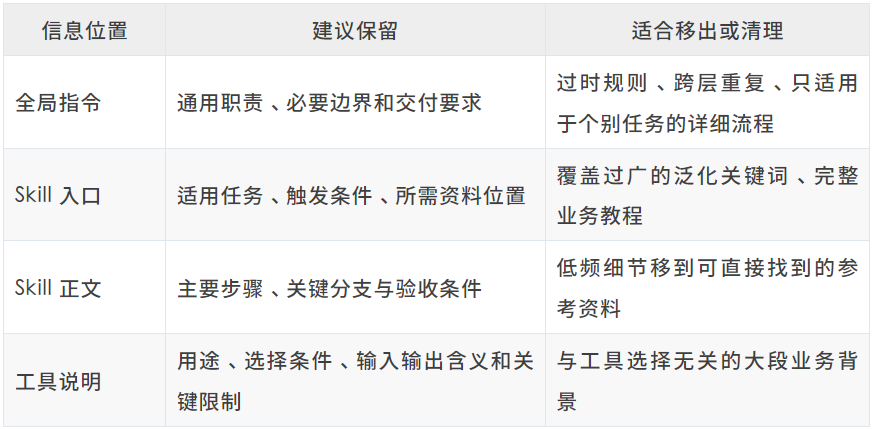
必须在选择或执行前生效的限制,要在相应阶段可见;不要为了主文件变短,把它藏到可能永远不会被读取的资料里。按需加载需要同时设计“何时读”和“读不到怎么办”。
让 LLM 帮忙修改指令时,也可以把要求从“扩写得更详细”改成:
请找出这份指令中的遗漏、歧义、冲突和重复。保留必要边界与例外;每项修改说明它解决的具体问题、可能改变的行为,以及如何验证。无法从现有信息确认的业务条件,请标为待确认,不要自行补成规则。
05
怎样判断自己的修改有没有用?
先明确要解决的是质量还是成本。遗漏条件、混淆规则、选错资料属于质量问题;重复输入过多、响应慢、维护困难属于成本问题。一份指令可能质量可用但成本偏高,也可能很短却缺少必要信息。
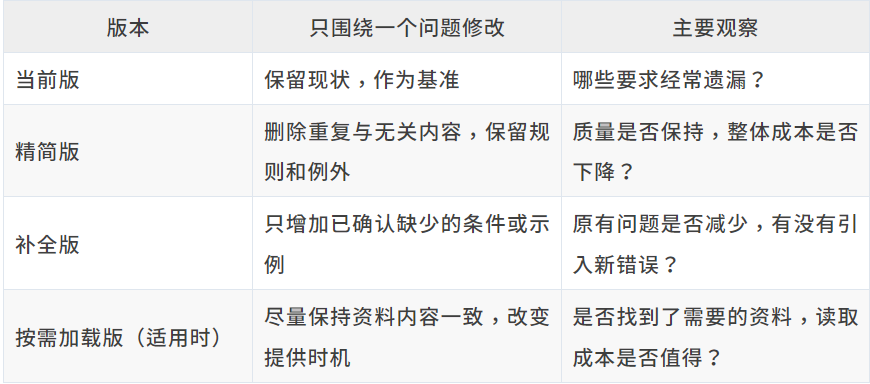
- 先定验收标准。 日志分析至少检查服务与时间范围、原始证据引用、不确定性标注,以及有没有把推断写成事实。
- 固定比较条件。 使用相同模型、设置和一组真实任务;避免同时更换模型、重写规则、改工具,否则难以判断收益来源。
- 保留未参与修改的任务。 用已知失败定位问题,再用留出的任务检查是否只修好了熟悉案例;不要凭一次成功决定长期版本。
- 同时记录质量与整体成本。 关注首次合格情况、关键遗漏、修复次数、用量、费用与耗时;小幅差异需要更多重复与任务支持。
输入更短却需要多轮纠错,整体成本未必更低;增加少量必要条件,如果能减少错误和返工,也可能更划算。模型自称“已全面检查”、回答更长或更自信,都不能替代实际验收。
下一次准备给指令追加一段话时,先写清楚:它要修复哪个已观察到的问题?什么结果能证明它有用? 删除或拆分内容时也做同样的判断。长度是需要观察的变量,是否解决问题才是保留改动的依据。
补充阅读:另外四项研究提供了什么线索?
下面的研究补充了长期遵循、动态示例与反馈优化的证据。它们没有把字数作为唯一变量,因此适合用于理解修改方向。
HANDBOOK.md:写进手册,不等于稳定执行
65 项任务对应 20–124 页手册,包含 824 项程序化验收标准;评分检查最终状态及行为,不使用 LLM 评分器。最佳严格 pass@1 为 36.2%,即一次尝试满足全部要求的概率;每项任务重复 4 次用于估计这一指标,并非四次中成功一次即可。允许漏掉一个检查项时,领先配置的得分大致翻倍,显示少数遗漏即可影响交付。手册长度、要求数量和任务难度并未被单独控制,因此不能据此推导“删短就能解决”。论文 · v3 · 2026-08-03
DynaContext:稳定指令与动态资料可以互补
在元器件参数抽取的异构评测中,基础指令的平均字段 F1 为 51.8;仅加入动态示例为 59.2;仅优化通用指令为 66.9;两者结合为 71.0,均按百分制展示。评测在类别与字段定义已给定的条件下进行,有效评分记录包含 850 项标注事实。它支持针对当前任务补充信息;数据来自单一工业语料,不能当作自动识别类别到完成任务的全流程成绩。预印本 · 2026-08-22
SkillOpt:有效修改可以是增加、删除或替换
SkillOpt 固定执行模型,根据带评分的执行结果,对外部 Skill 做有限的增加、删除与替换,验证分数提高才接受修改。作者报告在 52 个“模型 × 基准 × 执行框架”评估单元中最好或并列最好。它没有把变长设成目标,更值得借鉴的是用反馈筛选修改,而不是让 LLM 无依据地扩写。预印本 · v2 · 2026-05-25
OEO:一次性重写,在不同任务上可能方向相反
OEO 的一次性重写对照中,GPT-5.5 只读起始指令与静态任务说明,不查看执行反馈。重写在 SearchQA 上改善,在 LiveMath 上退化,四组均未达到有反馈优化的成绩。下表按百分制展示,每行只与自身基线比较。预印本 · 2026-08-10 · 表 3
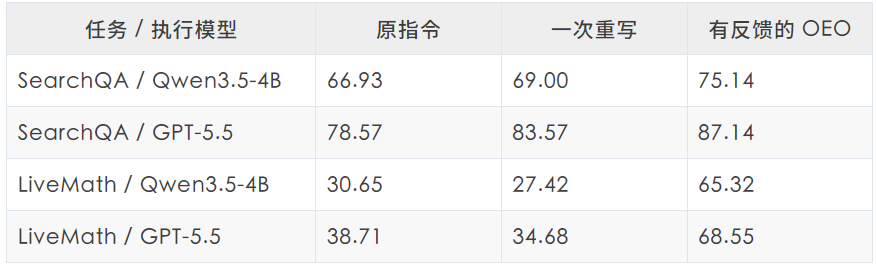
它说明重写稿即使看起来更通顺、更完整,也需要用任务结果判断价值;有反馈的优化需要额外调用与成本,收益并非免费获得。
-End-
原创作者|王鸿宇
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号